最上位AIモデルは何に使うべき?高性能モデルが向く仕事・向かない仕事と実例
ChatGPT、Claude、Geminiのモデル選択画面には、応答の速さや利用量を重視したモデルと、各社が最も高い能力を持つものとして提供するモデルがあります。有料プランを利用していても、「最上位モデルへ替えると、実際に何ができるようになるのか」「メールや要約にも使った方がよいのか」は分かりにくいでしょう。
現在の最上位モデルは、Webを調べ、ファイルを読み、表を計算し、画像や画面を確認しながら、数時間にわたる仕事を進められるようになっています。これにより、AIへ任せられる範囲は、難しい質問への回答から、 調査、判断、制作、修正をつないで完成物を作る仕事 まで広がっています。
たとえば、キャッチコピーを10案出すだけなら、標準モデルでも十分な結果を得られることがあります。一方、新商品のキャンペーン全体を任せる場合は、AIに求める能力が変わります。商品情報や顧客調査をもとに訴求を決め、それを広告、スライド、Webページへ展開し、修正後も表現や数字の整合性を保つ必要があるからです。 複数の制作物を一つの方針でまとめ、修正後まで整合性を保つ仕事は、最上位モデルの能力を生かしやすい用途です。
複数の工程をつなぐ力は、クリエイティブ制作に加えて、専門的な調査、長時間動くAIエージェント、大規模な開発、科学研究でも使われます。一方、表記統一、項目抽出、短い言い換えなど、手順が決まった処理では、応答の速いモデルの方が使いやすいでしょう。
この記事では、最上位AIモデルで変わる能力と6つの主要な使い道を整理します。OpenAI、Anthropic、Googleによる公式の位置づけ、公式以外の公開例、Web版やローカルアプリから自分で使う場面も取り上げます。高性能モデルでも残るハルシネーションと、出力を仕事で使うための確認方法まで解説します。
この記事のまとめ
- 最上位AIモデルは、デザインや資料などの制作、長時間のエージェント作業、専門分析、厳しいレビュー、複雑な開発、高度な研究へ使うと能力を生かしやすくなります。
- 高性能モデルの違いは、推論力だけでなく、複数の道具を使う力、長い仕事を続ける力、途中の修正を反映して完成させる力にも現れます。
- OpenAI、Anthropic、Googleはいずれも、短い定型処理より、複数工程や専門知識を含む仕事を最上位モデルの中心用途にしています。
- Web版では最上位モデルの利用可否を確認し、ローカルアプリの長いタスクでは選んだモデルを維持します。別モデルを使う工程は独立したタスクに分けます。
- 最上位モデルもハルシネーションを起こすため、出典、数値、原文、完成条件の確認は必要です。
1. 最上位AIモデルは、AIに任せられる仕事の上限を広げる
この記事でいう最上位AIモデルとは、OpenAI、Anthropic、Googleなどが提供するモデルのうち、 複雑な推論、長時間の作業、専門的な成果物などで最も高い能力を持つ選択肢 を指します。GPT-6 Astra、Claude Fable 5.1、Gemini 3.8 FlashやGemini 3 Deep Thinkなどが例です。「高級AIモデル」「プレミアムモデル」と呼ばれることもあります。
会社によって提供方法は異なります。独立したモデルとして選ぶ場合もあれば、特定モデルの高度な思考モードとして提供される場合もあります。契約プランや利用画面によって、選択できる最上位モデルも変わります。
標準モデルと最上位モデルには、文章作成、調査、分析、画像の確認、コーディングなど、多くの共通する機能があります。 扱う情報、続ける工程、守る条件、求める完成度が増えるほど、モデルの能力差が結果に表れやすくなります。
能力差は、仕事が長くなるほど積み重なる
一つの質問への回答では、標準モデルと最上位モデルの差が小さい場合があります。仕事が長くなると、最初の小さな違いが後の工程へ影響します。
たとえば、1回の会議メモを要約する程度なら、標準モデルでも対応できます。一方、半年分の売上表、広告レポート、問い合わせ、会議記録を調べ、業績が伸びない原因と改善策を経営会議用の資料へまとめる場合は、工程ごとに判断が発生します。資料によって数字や意見が食い違う可能性もあるため、それぞれの関係を確認しながら結論を組み立てる必要があります。
この仕事では、次の能力が完成物を左右します。
- 情報を読み分ける
売上、広告、問い合わせ、会議記録から、原因の判断に使える情報を選ぶ。 - 全体を設計する
何を原因として調べ、どの順番で経営会議へ説明するかを決める。 - 道具を使う
必要な情報を検索し、表を計算し、画像や表示結果を確認する。 - 条件を保つ
対象期間、集計条件、予算、期限を分析と改善案へ反映する。 - 修正を全体へ広げる
新しい数字や担当者の指摘を、結論、グラフ、改善案へ反映する。
最上位モデルは、このように複数の能力を同時に使う仕事で、AIへ任せられる範囲を広げるために選びます。 一つの文章、一枚の画像、一回の要約では、各工程をつなぐ能力を使う場面が少なく、モデルによる差も小さくなります。
標準モデルで同じ仕事を進める場合、人が工程ごとに判断し、細かく指示を出す場面が増えます。最上位モデルを使う価値は、こうした指示や判断の回数を減らし、複数の成果物をそろえる手間をどこまで抑えられるかにも表れます。
そのため、最上位モデルを使う候補になるのは、 成果物の質が売上や評価へ影響する仕事、複数工程をまとめて任せたい仕事、途中の見落としが全体へ広がる仕事 です。完成条件が明確な短い処理には、応答が速く利用量も抑えやすい標準モデルが適しています。
最上位モデルとHigh・Maxは別に選ぶ
モデルの選択とReasoning effortは別の設定です。モデルを替えると基礎能力、得意分野、利用できる機能などが変わります。Reasoning effortを上げると、選んだモデルが回答前の計画、比較、見直しへ使う処理量が増えます。
| 選択するもの | 主に変わること | 選択例 |
|---|---|---|
| AIモデル | 基礎能力、得意分野、長い仕事への対応力、利用できる機能 | 標準モデルから最上位モデルへ替える |
| Reasoning effort | そのモデルが計画、比較、検証へ使う処理量 | MediumからHighへ上げる |
標準モデルをHighで使うことも、最上位モデルをMediumで使うこともできます。推論量はモデルの使い方を調整し、モデル選択は基礎能力や得意分野を変えます。最上位モデルでも、簡単な仕事に最大の推論量を使うと、回答が遅くなったり利用枠を多く使ったりする場合があります。
Gemini Deep Thinkのように、高度な推論機能がモデル内の思考モードとして提供される例もあります。モデル選択画面では、 どのモデルを使うか、そのモデルへどこまで検討させるかを分けて確認します。
推論レベルごとの違いと使い分けは、「Reasoning effortとは?ChatGPT・Claude・Geminiの推論レベルで何が変わるか」で詳しく解説しています。ここからはモデル自体の違いに焦点を戻し、最上位モデルで差が出やすい能力を確認します。
2. 最上位モデルは、推論・長時間作業・ツール利用・制作で差が出る
高性能なAIモデルというと、難しい質問へ正解できる「頭のよさ」に注目しがちです。実際の仕事では、 長い作業を続ける、複数の道具を使う、異なる形式の情報を扱う、修正を重ねて完成させる といった能力も結果を左右します。
標準モデルも、長時間の作業やツール利用などに対応しています。難易度が上がると、条件を保ったまま最後まで進められるかにモデルごとの差が出ます。さらに、得意分野もモデルごとに異なるため、科学や数学、デザイン、文章、画面操作など、今回使う能力に合わせて選ぶ必要があります。
最上位モデルの使い道を考えるときは、次の能力のうち、今回の仕事でどれを使うのかを確認します。
| 見る能力 | 仕事で現れる違い |
|---|---|
| 推論と判断 | 複数の仮説、前提、反対意見を比べ、次に何を確認するか決める |
| 長時間の作業 | 途中の結果に合わせて計画を変えながら、複数工程を完了する |
| 情報の横断 | 文書、表、画像、Webページに分かれた情報を関係づける |
| ツール利用 | 検索、表計算、ファイル操作、ブラウザー操作などを選んで使う |
| 制作と修正 | 目的と条件を保ち、初稿から使える成果物へ仕上げる |
| レビュー | 条件漏れ、矛盾、弱い根拠、別の解釈を見つけて改善する |
複数の仮説を比べ、次に調べることを決める
難しい分析では、複数の仮説を比較しながら答えへ近づきます。新商品の返品が増えた原因を調べる場合も、商品説明、価格、配送、品質、購入者層など、複数の可能性があります。
高性能モデルには、 考えられる仮説の整理、根拠と弱点の比較、判断に足りない情報の特定 まで依頼できます。追加で見るべき数字や質問が分かれば、人は調査の次の一手を決めやすくなります。
この能力は、事業分析だけでなく、企画の比較、契約上のリスク確認、研究、原因不明の不具合調査にも使われます。モデルが出した内容は仮説として扱い、元データや一次情報で確かめられる形にします。
長い仕事では、計画を保ちながら途中で立て直す
数時間にわたる仕事では、調査先が見つからない、資料同士の数字が合わない、途中で新しい条件が加わるなど、計画を見直す場面が発生します。
長時間の作業では、 現在の目的と完了した工程を把握し、残りの作業を組み直す力 が、完了まで進められるかを左右します。そのため、多数のファイルを読み、検索や操作を繰り返すAIエージェントやローカルアプリでは、この能力が高いモデルを選ぶ価値が大きくなります。
コンテキストウィンドウの大きさは、一度に扱える情報量を示します。長い仕事の完成には、この情報量に加えて、重要な条件を保ち、途中の失敗を修正する力も関わります。作業経過を記録し、節目ごとに成果物と残作業を確認すると、モデルが目的から外れた場合も早く修正できます。
ツール利用の差は、次の行動の選び方に表れる
現在のAIは、Web検索、ファイル検索、表計算、コード実行、画像確認、ブラウザーやアプリの操作など、利用画面に用意された道具を使えます。モデルによる差は、 目的に合う道具を選び、得られた結果から次の行動を決める場面 で表れやすくなります。
たとえば、競合サービスを調べる仕事では、Web検索に続いて、公式ページから機能と料金を確認し、比較表へ整理します。さらに自社の条件と照合し、不明な点を追加で調べ、最終的な資料へ反映します。途中で情報が古いと分かれば、別の出典を探す必要もあります。
競合調査では、検索に加えて、採用する出典の選択、比較項目の確認、数字と結論の照合まで行います。こうした作業を任せる場合は、モデルの能力とあわせて、利用する画面で検索や表計算などの機能を使えるかも確認しておきましょう。
制作物は、修正後の完成度まで評価する
ツール利用の広がりによって、最上位モデルは、文章、画像、図表、スライド、Webページなどを組み合わせた制作にも使われるようになりました。作れるものは利用画面や連携機能によって異なりますが、AIへ任せられる範囲はデザイン・クリエイティブ領域にも広がっています。
制作物を仕事で使うには、初稿の見栄えに加えて、 目的、対象者、ブランド、事実関係を保ったまま、指摘を反映して仕上げられること が重要です。「価格を変更する」「対象者を変える」「説明を短くする」といった修正を重ねると、文章、表、画像の食い違いも起こりやすくなります。
そのため、制作に使うモデルは、初稿の見栄え、修正後の条件維持、別の制作物との整合性、最終確認にかかる時間で評価します。次章では、ここまで説明した能力を生かせる用途を、クリエイティブ制作から順に紹介します。
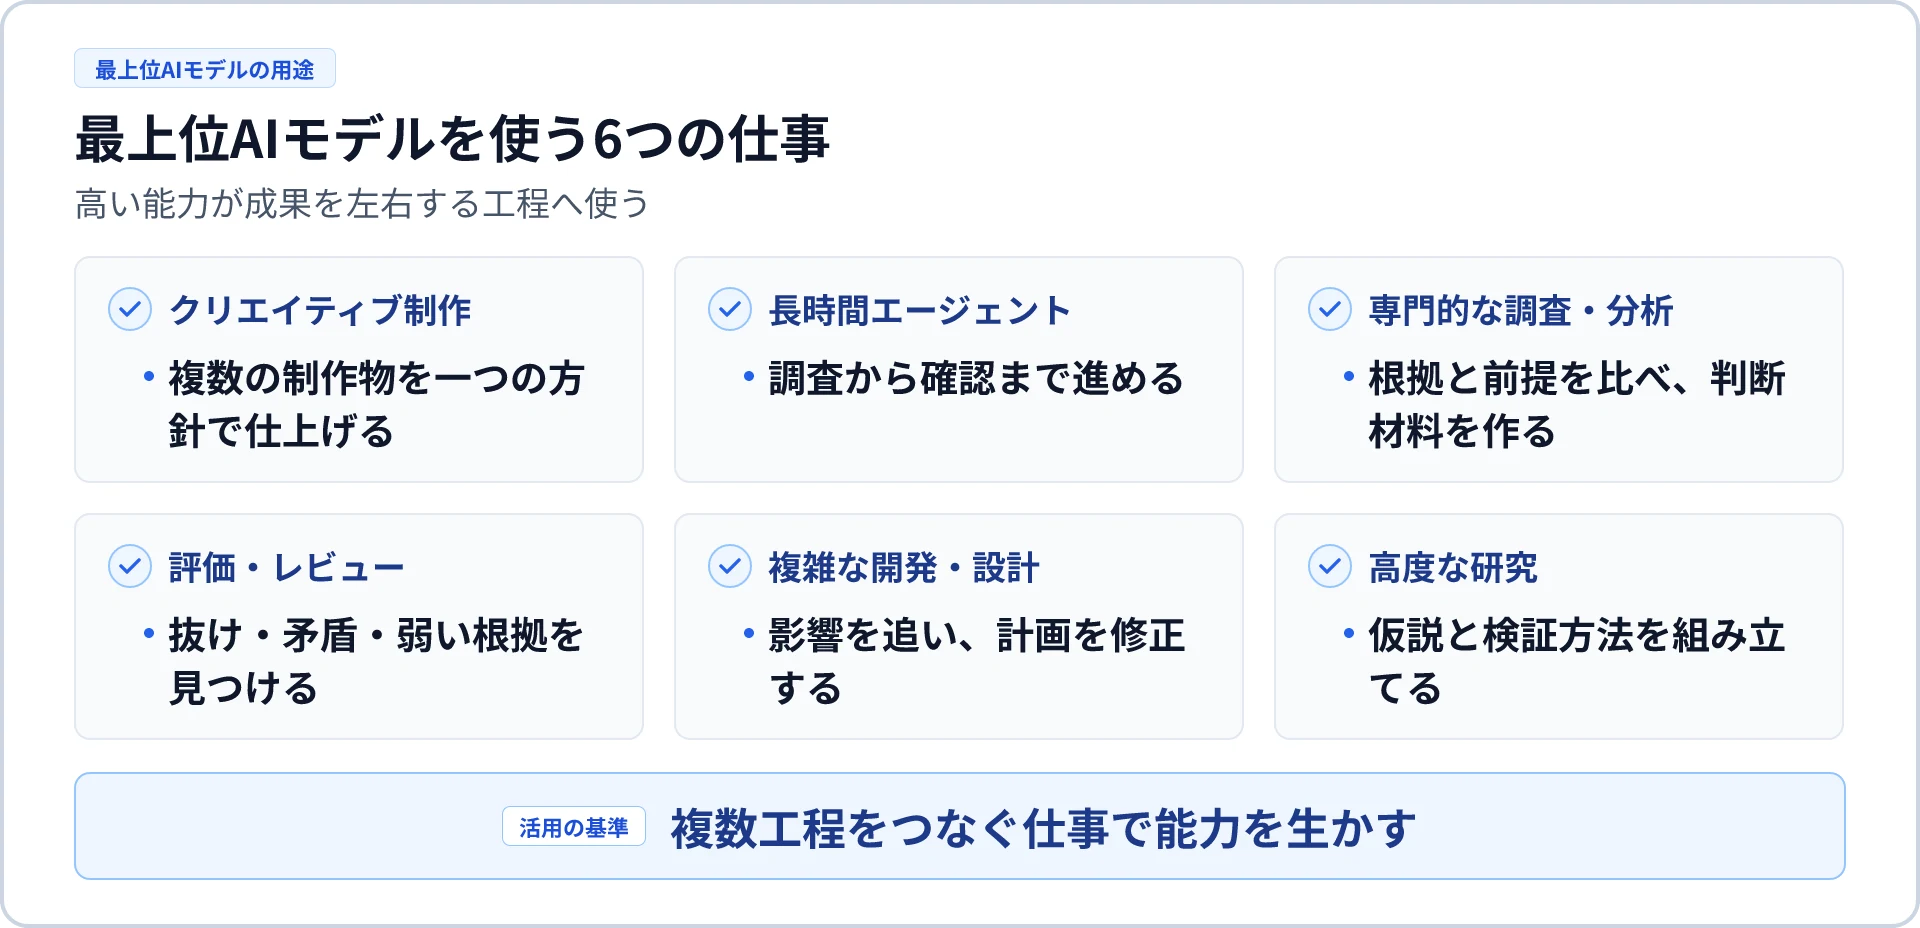
3. 最上位AIモデルを使う価値が大きい6つの用途
最上位モデルの使い道は、業務名よりも、AIへ任せる範囲によって変わります。 たとえば、資料作成でも、決められた文章をスライドへ配置する作業と、調査から構成、デザイン、修正まで進める仕事では、使う能力が異なります。
ここでは、最上位モデルの高い能力を使いやすい用途を、日常の仕事に近い順から紹介します。
1. デザイン・資料・Web・動画などの制作物を仕上げる
最上位モデルを使いやすいのは、 文章、画像、図表、レイアウトを組み合わせ、複数の制作物を一つの目的に合わせて仕上げる仕事 です。現在は、文章の生成に加えて、画像の確認、スライド作成、Webページの編集、デザイン案の比較などを行えるサービスが増えています。
たとえば、オンライン講座を作る場合は、対象者と到達目標を決め、カリキュラム、台本、スライド、図解、紹介ページを用意します。途中で講座の対象者や内容が変われば、関連する制作物もまとめて修正します。
このような仕事では、個々の文章や画像の出来に加えて、全体の順番、説明の重複、用語、デザイン、事実関係がそろっているかが完成度を左右します。 最上位モデルには、一つの素材を作る役割より、制作物全体を設計し、修正後まで整合性を保つ役割を任せると、能力を使いやすくなります。
ただし、実際に作れるファイルや操作できるアプリは、利用するサービスと画面によって異なります。モデルの性能と、画像生成、スライド編集、ブラウザー操作などの機能を分けて確認してください。
2. 長時間動くAIエージェントへ、一連の仕事を任せる
AIエージェントは、目的を受け取った後、自分で作業を分け、必要な情報や道具を選びながら進めます。最上位モデルは、 人が一工程ずつ指示していた調査・整理・作成・確認を、長い一つの仕事としてつなげる用途 で使われています。
たとえば、競合サービスの調査では、調査対象と比較項目を決め、各社の公式ページを確認し、料金と機能を表へ整理します。その後、自社の条件と照合し、候補を絞り、判断理由と出典を含む資料へ仕上げます。途中で料金体系が異なると分かれば、比較方法も組み直します。
こうした作業では、検索結果を要約する力より、 現在地を把握し、次に必要な作業を選び、確認が終わるまで進める力 が重要です。Web版のエージェント機能なら調査や資料作成、ローカルアプリなら多数のファイルを使った制作や開発など、利用環境によって任せられる範囲が変わります。
長い仕事では、AIが誤った前提のまま先へ進む可能性もあります。作業の節目で、確認済みの情報、残っている作業、人の判断が必要な点を報告させると、途中のずれを修正しやすくなります。
3. 専門的な調査・分析から、判断材料を作る
事業や費用に関わる判断では、集めた情報の量より、根拠と前提を区別し、複数案の利点とリスクを比較できるかが重要です。最上位モデルには、 調査結果を並べるところから一歩進み、意思決定に必要な論点を組み立てる役割 を任せられます。
企業では、買収前の調査、財務分析、契約条件の比較、市場参入の検討などに高性能モデルが使われています。個人や小規模な事業でも、新しい事業を始める前の市場調査、高額な業務サービスの選定、大型案件へ応募する前の採算確認など、判断を誤ったときの影響が大きい場面があります。
この用途では、AIに結論だけを求めると、もっともらしい一案へ偏る可能性があります。候補ごとの前提、根拠、弱点、追加で確認する情報を分けて出させると、判断材料として使いやすくなります。 最終決定は人が行い、AIは検討できる選択肢と見落としを増やすために使います。
4. 他のAIや人が作った案を、評価・反論・改善する
最上位モデルは、最初の案を作る役割だけでなく、完成前の評価にも使えます。標準モデルや人が作った企画書、記事、スライド、分析結果を渡し、 条件の抜け、根拠の弱さ、数字と結論の不一致、別の立場からの反対意見 を確認させます。
たとえば、営業提案を顧客の経営者、現場担当者、経理担当者の立場から読ませると、同じ資料でも異なる疑問が出ます。記事なら、初めて読む人が理解できるか、主張を裏づける情報があるか、似た説明が続いていないかを分けて確認できます。
この使い方では、作成や整形を標準モデルで進め、 採用案を決める場面や、公開前の厳しいレビューへ最上位モデルを使います。 作成とレビューを別の会話やモデルへ分けると、最初の案に引っ張られにくくなります。
5. 複雑な開発・設計・セキュリティ分析を進める
公式や第三者の事例では、最上位モデルの用途として開発が多く挙げられています。大規模なソフトウェアでは、数多くのファイルや既存仕様を理解し、変更範囲を決め、実装、テスト、修正まで続ける必要があるためです。
具体的には、原因が分からない不具合の調査、複数機能にまたがる変更、システム全体の設計、セキュリティ上の弱点の分析などがあります。 一部分のコードを書く能力より、変更による影響を追い、テスト結果から原因や計画を修正する能力 が完成までの時間を左右します。
開発は結果をテストで確認しやすく、モデルの能力差を比較しやすい分野でもあります。この評価のしやすさから、開発の公開事例が豊富にあります。そこで使われる長時間の計画、ツール利用、途中修正は、調査や制作でも最上位モデルを選ぶ理由になります。
6. 高度な研究と、正解が決まっていない問題を検討する
科学、数学、工学などの研究は、最上位モデルの能力が試される代表的な分野です。既存の文献から答えを探すだけでなく、 データが不完全な状況で仮説を立て、複数の方法を比べ、次の検証方法を考える 力が使われます。
実際の公式事例には、専門的な数学論文の論理確認、材料の製造方法の検討、ゲノム解析に使う統計手法の選択などがあります。研究者は、AIへ最終的な正解を決めさせるより、仮説、計算方法、反証の可能性を広げるために使っています。
高度な専門知識を扱い、専門家がAIと検討できる範囲を広げることも、最上位モデルの重要な価値です。 次章では、OpenAI、Anthropic、Googleが、それぞれの最上位モデルや思考モードをどの用途へ位置づけているかを確認します。
4. OpenAI・Anthropic・Googleは、最上位モデルを何へ使っているか
前章で紹介した6つの用途は、各社の公式な説明にも表れています。3社が最上位モデルで強調する仕事には違いがあります。 OpenAIはブラウザーや業務ソフトをまたぐ仕事、Anthropicは長時間のエージェントと知識業務、Googleは一般業務向けの高速な推論と科学・研究向けの深い検討を重視しています。
OpenAI:ブラウザーや業務ソフトを使い、制作まで進める
OpenAIは、GPT-6 Astraの公式モデルガイドで、コンピューター操作、ブラウジング、ソフトウェア開発、科学、専門業務で高い性能を持つモデルと説明しています。特に重視されているのが、コード、ブラウザー、業務ソフトを使う複数段階の仕事です。
公式の開発者向け記事では、Astraを使って住宅の3DシーンをBlenderで作り、家具や庭を加え、Unreal Engine 5で確認しながらカメラツアーまで仕上げた例が紹介されています。 編集できる3Dデータを作り、別のソフトで確認し、日常生活の細部まで何度も修正した制作例 です。
この例から分かるのは、Astraの使い道が文章やコードの生成に収まらず、複数のソフトと成果物をつないだ制作へ広がっていることです。調査、デザイン、ファイル編集、表示確認が続く仕事ほど、コンピューター操作と長い作業を組み合わせる能力が使われます。
Anthropic:長時間のエージェントと知識業務を進める
Anthropicは、Claude Fable 5.1の発表で、同モデルを長時間のコーディングと知識業務へ向けた最上位モデルと位置づけています。数時間から数日にわたる仕事を進め、途中で得た結果に合わせて計画を更新する用途が中心です。
企業の仕事では、資料を一度要約するだけでなく、複数の文書や表を読み、問題を特定し、関係者が使える成果物へまとめるまでに多くの判断が発生します。 長い作業の中で文脈を保ち、調査、判断、作成、修正をつなぐ力 が、Anthropicの最上位モデルを使う理由になります。
なお、次章で紹介する第三者比較は、Claude Opus 5を対象にしています。現在の最上位モデルと混同せず、その時点の成果物を評価した事例として読みます。
Google:一般業務はGemini 3.8 Flash、科学・研究はDeep Think
Googleは、Gemini 3.8 Flashの発表で、推論、コーディング、エージェント作業を速く進めるモデルとして紹介しています。一般的な知識業務では、複数の資料や道具を扱いながら、待ち時間を抑えて作業を続ける用途が中心です。
一方、Gemini 3 Deep Thinkの公式記事では、Deep Thinkを科学、研究、工学向けの高度な推論モードと説明しています。手描きのスケッチから3Dプリンター用の形状を設計した例、人の査読を通過した数学論文の問題を見つけた例、結晶を成長させる手順を研究チームと検討した例が紹介されています。
一般業務を速く広く進めるモデルと、時間をかけて複数の解き方を検討する専門モードでは、同じGoogleの中でも用途が異なります。 モデル名の順位だけで決めず、日常の制作や分析なのか、科学・研究の難問なのかを先に確認します。
公式事例は、使い道を知る材料として読む
3社の公式情報を比べると、最上位モデルの用途は、文章回答から、長時間の操作、専門分析、制作、設計へ広がっています。一方で、ここに掲載された顧客コメントや先行利用例は、各社が選んだ事例です。
そのため、公式事例からは、各社が最上位モデルへ期待する能力と用途を読み取ります。通常モデルとの同条件比較や、あらゆる仕事で得られる効果は、第三者の比較や自分の成果物も合わせて判断します。次章では、公式以外の公開比較で評価された違いを紹介します。
5. 第三者の比較では、成果物の違いと段階的な使い方が見える
公式事例は各社が目指す用途を知る材料になりますが、実際の選択では、第三者がどのような課題を与え、成果物の何を評価したかも参考になります。公開されている比較では、単純な点数に加えて、 分析のまとめ方、要件を守る力、検証できるかどうか が評価されています。
事業分析では、情報量だけでなく因果関係と伝え方が評価された
Tom's Guideは、Claude Opus 5とKimi K3に15問の難しい課題を与え、回答を比較しています。事業分析の課題では、大手動画配信サービスが生成動画の新興企業を買収したという想定を置き、必要になるインフラや事業への影響を分析させました。
Kimi K3は技術面を広く詳しく整理し、Opus 5は経営層が判断しやすい形にまとめたと評価されています。別の課題では、企業向けIT会社の業績悪化について、AIによる開発方法の変化がクラウド契約の更新へ及ぼす影響を説明させました。この課題でOpus 5は、複数の出来事を一つの因果関係としてつなげた点が評価されました。一方、Kimi K3には、推測に基づく細かな数値を加える場面があったと指摘されています。
この比較から、最上位モデルへ事業分析を任せるときは、情報量だけで評価せず、 誰の判断に使うのか、根拠と推測を分けているか、出来事の関係を説明できているか まで見る必要が分かります。なお、Tom's Guideの比較は、一人の執筆者が架空の課題で行った評価です。この一件をすべての実務やモデルへ一般化せず、成果物を見る観点として利用します。
難しい開発では、要件を保ちながら完成させる力が比較された
Tom's Guideの15問には、複数のAIが役割分担する開発環境や、テストを前提にしたブラウザー拡張機能の設計も含まれています。評価では、要件、セキュリティ、運用方法を含めて、実行できる計画へ落とし込めるかが重視されました。
開発の公開比較が多い理由の一つは、テストや動作確認によって結果を判定しやすいことです。ただし、ここで評価される 長い要件を保つ力、工程を分ける力、問題が起きた後に計画を直す力 は、キャンペーン制作、調査資料、業務設計にも共通します。自分の仕事へ置き換えるときは、業種よりも、AIへ任せた工程の長さと確認方法に注目すると使い道を判断しやすくなります。
結果を自動確認できる仕事は、失敗したタスクだけ上位モデルへ回せる
Lee Penkmanが公開した27件のコーディング課題による検証では、課題ごとに安価なモデルから試し、テストを通らなかった課題だけ次のモデルへ回しました。その結果、この小規模な課題群では、単独モデルより低い費用で全課題を完了しています。
ここで切り替えているのは、長く続けた一つのチャットではなく、結果を個別に判定できる課題です。 同じ長いチャットでモデルを何度も往復する運用を示した検証ではありません。
この検証の対象は、著者が作成した27件のコーディング課題です。結果の範囲は限られます。それでも、正解を自動確認できる独立した処理は標準・軽量モデルで始め、失敗した処理だけを最上位モデルへ渡す考え方は、大量処理の費用や利用枠を抑える参考になります。
日常業務でも、定型レビューや項目抽出を別タスクとして処理し、判断が難しい例外だけを最上位モデルへ渡せます。長い制作や調査では同じモデルを維持し、別モデルを使う必要がある工程は、決定事項と対象ファイルを渡した別タスクへ分けます。 最上位モデルの使い道は、高い能力が成果を左右する独立した作業単位から決めます。
6. Web版やローカルアプリから、自分の仕事へ使う場面
公式事例や比較記事を読んでも、自分の仕事で使う場面まで想像しにくいことがあります。 Web版やローカルアプリへ資料を渡し、最上位モデルの能力を使いやすい場面を具体的に紹介します。
共通しているのは、 多くの資料を読み、方針を決め、複数の成果物を作り、確認と修正まで続ける仕事 です。
大きな制作物を、企画から仕上げまで進める
会社のブランドサイトを全面改訂するために、現在のサイト、アクセス分析、顧客インタビュー、商品資料、ブランドガイドをAIへ渡す場面を考えてみましょう。最上位モデルには、課題と訴求の候補を比較させ、サイト全体の方針を決め、ページ構成、文章、図解、画像案へ展開させます。
初稿の後は、「対象者を絞る」「商品の説明順を変える」「スマートフォンで読みにくい部分を直す」といった指摘を全ページへ反映します。 企画、文章、デザイン、複数ファイルの修正を一つの方針でつなぐ範囲まで任せることで、最上位モデルの長い文脈と制作能力が生きます。
ローカルアプリで既存のファイルを直接扱えるなら、資料の読み込み、ページの編集、表示確認まで進められます。Web版でも、ファイル添付、検索、画像やスライドの作成など、利用できる機能の範囲で同じ考え方を使えます。
重要な提案や審査に向け、条件の多い成果物を作る
大型案件の提案、公募への応募、融資や補助金の申請では、募集要項、評価基準、自社の実績、見積もり、提出形式を同時に満たす必要があります。最上位モデルには、要件を一覧化させた後、採用される可能性のある方針を比較し、提案の流れを設計し、本文や図表まで作らせます。
初稿ができたら、審査側の視点で、評価項目への回答がどこにあるか、根拠が弱い主張はどれか、見積もりと実施内容が対応しているかを確認させます。 作成と審査の両方を複数回行い、長い要件を最後まで保つ仕事 は、高い推論力とレビュー能力を投入する価値が大きい場面です。
大きな投資や事業変更の前に、判断材料をまとめる
新しい店舗や事業への投資、主要な業務サービスの乗り換え、高額な設備の購入では、価格だけで決めると、運用や契約の条件を見落としやすくなります。候補の公式情報、見積書、契約書、自社の利用状況、担当者の意見をAIへ渡し、比較の前提から整理させます。
最上位モデルには、各案の費用、導入期間、解約条件、運用負担、想定される効果を関連づけ、意見が分かれる理由と追加で確認する質問をまとめさせます。最終判断は人が行い、AIには 判断できるところまで論点と証拠をそろえる役割 を任せます。
通常モデルや人が作った重要資料を厳しくレビューする
すでに企画書や記事、分析資料ができている場合は、最上位モデルを最後のレビューへ使えます。目的、対象者、評価基準、元資料を渡し、内容の抜け、論理の飛躍、数字の不一致、反対意見、誤解される表現を分けて確認させます。
修正案を出させる前に、問題箇所と影響を一覧化させると、人が採用する修正を選びやすくなります。その後、修正した成果物をもう一度条件と照合します。 作成を標準モデルで進めた場合は、完成物、元資料、確認項目を渡した別タスクで最上位モデルにレビューさせます。 利用枠を抑えながら、作成時とは別の視点で完成度を上げられます。
ここまでの場面は、最上位モデルの能力を使うほど、任せられる工程や確認の深さが広がる仕事です。次章では反対に、処理内容が決まっていて、速さや量が重視される仕事を取り上げます。
7. 整形・抽出・短い生成・大量処理では、標準・軽量モデルが使いやすい
処理内容が決まっている仕事では、高い推論力を使う場面が少ないため、標準・軽量モデルの方が効率よく進むことがあります。 最上位モデルで対応できる仕事でも、応答時間や利用枠まで含めて使い分けます。
判断の基準は、仕事の重要度に加えて、 その工程でAI自身が方針を決める必要があるか です。重要な資料でも、決定済みの表記へ直す工程なら、軽いモデルで処理できます。
表記統一・短い言い換え・決められた形式への変換
全角と半角の統一、見出し形式の変更、指定文字数への短縮、決まった雰囲気への言い換えは、完成条件が明確です。標準・軽量モデルへルールと例を渡せば、短時間で処理できます。
一方、どの表現をブランドの中心にするか、複数の案から企画方針を決めるかといった判断では、最上位モデルの能力を使いやすくなります。 方針を決めるタスクと、決まった方針を反映する定型処理を分ける と、モデルを選びやすくなります。
項目抽出・分類・タグ付け
請求書から日付と金額を抜き出す、問い合わせを決められた種類へ分類する、商品へ既存のタグを付けるといった仕事も、判断基準を固定できます。件数が多い場合は、軽量モデルで処理し、人が一部を抜き取り確認する方法が効率的です。
分類基準そのものを作る段階では、境界事例を集め、分類同士の重なりを見直す必要があります。この設計を最上位モデルへ任せ、確定した基準と対象データを別タスクの軽量モデルへ渡すと、能力と処理量を両立できます。
同じ処理を大量に繰り返す仕事
数千件の商品説明を同じ形式へ直す、毎日のデータを同じ項目で要約するといった大量処理では、一件ごとの小さな費用や待ち時間が積み重なります。まず少量のサンプルで品質を比べ、標準・軽量モデルが基準を満たすなら、そのモデルで全体を処理します。
例外だけを独立したリクエストや別タスクとして最上位モデルへ送れば、複雑な案件へ高い能力を集中できます。前章で紹介した振り分けは、処理件数が多いほど効果を出しやすくなります。
即時応答が重要な会話や操作
接客中の回答候補、音声会話、画面操作の補助などは、考える時間が長いほど使いにくくなります。品質の差より数秒の待ち時間が業務へ影響する場面では、応答の速いモデルが適しています。
回答に大きな責任が伴う問い合わせでは、速度に加えて、正確さと確認体制が重要です。よくある質問は軽量モデル、規約の解釈や例外対応は担当者または最上位モデルへ渡すように、内容によって経路を分けます。
最上位モデルは、高い能力を使える工程へ集中させるほど価値が明確になります。 次章では、Web版、ローカルアプリ、APIで、利用枠や費用を踏まえてモデルを使う方法を整理します。
8. Web版・ローカルアプリ・APIでは、最上位モデルの使い方が異なる
同じ会社のモデルでも、Web版、ローカルアプリ、APIでは、利用できるモデル、機能、上限、料金の考え方が変わります。 有料プランでも、画面や契約によって最上位モデルの利用可否と上限が変わります。
2026年9月13日時点では、ChatGPTのGPT-6 Pro、Claude Fable 5.1、Gemini 3 Deep Thinkなどは、利用できる画面や対象プランが異なります。さらにChatGPTでは、同じサービス内でも通常のChatとWork・CodexでAstraの利用可否や利用枠が分かれています。たとえばPlusではAstraをWork・Codexで使えますが、通常のChatでGPT-6 Proを選べる対象には含まれません。契約前や重要な作業の前に、使いたい画面のモデル選択欄と公式の利用条件を確認してください。
Web版は、高性能モデルを日常的に選びやすい
有料のWeb版は、契約プランの利用枠で使う形が中心です。利用枠に余裕があれば、難しい相談や重要な制作では、Highなどの高い推論レベルや高性能モデルを積極的に選べます。
一般的な会話や資料作成では、残りトークンをほぼ意識せずに使えます。ただし、最上位モデルやDeep Thinkのような特別なモードには、対象プラン、回数、混雑時の制限が設けられる場合があります。 Web版では高性能モデルを普段から使い、最上位モデルだけは利用可否と上限を別に確認する のが実用的です。
2026年9月13日時点で、ChatGPTのGPT-6 Pro、Claude Fable 5.1、Gemini 3 Deep Thinkは、すべての有料プランや画面で共通して使えるわけではありません。GPT-6 Astraの機能や利用方法は、「GPT-6 Astraは何がすごい?できること・料金・推論強度を実例で解説」でも詳しく紹介しています。提供状況は変更されるため、固定の回数を覚えるより、使う直前にモデル選択欄と公式の利用条件を確認してください。
ローカルアプリは、長い作業ほど利用枠を消費しやすい
ローカルアプリでファイルを読み、検索や編集を繰り返す仕事は、一回の質問に見えても、内部では多くの処理が続きます。入力する資料が大きく、出力や修正回数が増えるほど、利用枠を早く消費します。OpenAIも、AstraはWork・CodexでGPT-5.6 Solより利用枠を速く消費する場合があり、作業内容、入出力の量、推論設定などで利用量が変わると案内しています。
ローカルアプリの長いタスクでは、 最初の方針、作成、確認まで同じモデルを維持する 方が、これまでの判断を保ちやすくなります。途中で標準モデルへ替え、最後だけ最上位モデルへ戻すと、切り替え先が長い履歴を読み直し、判断基準にもずれが生じる場合があります。
別モデルへ任せたい工程がある場合は、同じチャットで往復させず、目的、決定事項、対象ファイル、確認項目をまとめた別タスクに分けます。定型レビューだけを別タスクにする、完成した資料だけを渡して別の観点から確認する、といった分け方なら、元のタスクの流れを保てます。
API・組織利用は、成果物の価値と処理量から振り分ける
APIでは、モデルごとの入出力トークンやツール利用に応じて料金が発生します。大量の問い合わせ、分類、抽出をすべて最上位モデルへ送ると、処理費用が大きくなります。そこで、内容が明確な処理は軽量モデル、複雑な判断や例外は高性能モデル、特に難しい案件だけ最上位モデルへ回します。
APIでこの振り分けがしやすいのは、処理を独立したリクエストへ分け、結果を機械的に確認できるからです。個人がWeb版やローカルアプリを使う場合は、同じ長いチャットの途中で切り替えるのではなく、独立させられる処理だけを別タスクへ分けて応用します。
費用対効果は、完成物と人の作業まで含めて考える
モデルの料金や利用枠だけを見ると、最上位モデルは割高に見えます。しかし、重要な提案書を使える状態へ近づけ、複雑な調査の見落としや制作物の修正回数を減らせた場合は、人の作業時間まで含めた費用対効果が高まります。
反対に、短い整形へ最上位モデルを使っても、完成物の差は小さくなります。 料金に加えて、完成までに必要な人の確認・修正と、誤りが起きた場合の影響まで含めて選ぶ と、最上位モデルへ費用や利用枠を使う場面が明確になります。
9. 最上位モデルでも、ハルシネーションと見落としは残る
最上位モデルでも、存在しない情報を事実のように述べるハルシネーションや、資料内の重要な条件を見落とす可能性は残ります。 複雑な資料から詳しく自然な説明を作れても、文章の説得力と情報の正しさは分けて確認します。
この問題は、最上位モデルの用途を狭める理由というより、 重要な仕事をどこまで任せ、どこを人が確認するかを決める条件 です。
ハルシネーションの確率は、モデルの順位だけでは決まらない
高性能なモデルは、知識、推論、指示理解の向上によって、特定の評価では誤りが減ることがあります。ただし、ハルシネーションの発生率は、質問の種類、必要な知識、検索の有無、指示、評価方法によって変わります。そのため、「最上位モデルなら常に何%減る」と共通の数字で示すことは困難です。
約20万件のPythonとJavaScriptの質問を調べた2026年の研究では、存在しないパッケージ名を挙げる割合が、対象となった5モデルで4.62%から6.10%でした。この検証では、小型のClaude Haiku 4.5が最も低い割合を記録しています。 少なくともパッケージ名を答える課題では、モデルの大きさとハルシネーション率が単純な順番になっていません。
この研究が測ったのは、プログラミングで使うパッケージ名の誤りです。記事、契約、事業分析、科学研究では、用途ごとに同じ種類の課題と確認方法を用意して比べる必要があります。
文章の自然さと情報の正しさを分けて確認する
最上位モデルの回答は、説明が詳しく、主張のつながりも自然になるため、誤った情報を見抜きにくくなる場合があります。固有名詞、数値、日付、料金、制度、引用は、出典を示させたうえで元ページを開き、該当箇所まで確認します。
Web検索を使わせる場合も、リンクが付いているだけで確認を終えず、本文の主張をそのページが実際に支えているかを見ます。出典に書かれている事実、AIが計算・整理した内容、AIの推測を分けて表示させると、確認しやすくなります。
調査・計算・制作では、確認方法を変える
確認方法は成果物によって異なります。調査資料では出典と引用箇所、計算では元データと式、契約や規程では原文、制作物では依頼条件と実際の表示を確認します。
たとえば、スライドの文章が正しくても、グラフの数字や画像内の文字が異なることがあります。Webページでは、原稿上の内容に加えて、リンク、スマートフォン表示、フォームの動作も確認対象です。 利用者が実際に見る完成物を基準に確認します。
医療、法律、財務、安全に関わる判断は、誤りの影響が大きいため、資格を持つ専門家や責任者の承認を工程に残します。
最上位モデルによるレビューにも、確認項目を渡す
最上位モデルへ「間違いがないか確認して」と依頼しても、作成時と同じ前提に引っ張られ、見落としを繰り返す場合があります。作成とは別の会話やモデルへ移し、数値、条件、出典、反対意見、表示結果を項目ごとに確認させます。
AIのレビューで問題を絞り、人が元資料と完成物を確認すれば、すべてを最初から読み直す負担を減らせます。 最上位モデルは確認作業を深くするために使い、公開や契約などの最終判断は責任を持つ人が行います。
10. 最上位モデルの能力を引き出すには、目的と完成条件を渡す
最上位モデルへ「詳しく調べて」「良い資料を作って」とだけ指示すると、モデルは重視する点を推測して作業します。高い推論力やツール利用を成果へつなげるには、 目的、元資料、制約、任せる範囲、完成条件 をまとめて渡します。
指示には、AIが計画を立てるための情報と、人が成果物を評価する基準を含めます。
目的と利用者を先に伝える
最初に、誰が何を判断・実行するための成果物かを伝えます。同じ市場調査でも、経営者が事業参入を決める資料と、営業担当者が顧客へ説明する資料では、必要な数字、詳しさ、構成が変わります。
「新サービスについて調べる」より、「経営会議で参入の可否を判断するため、候補市場の規模、競合、初期費用、主なリスクを比較する」と伝えた方が、調査項目と成果物の形が定まります。 何を作るかより先に、何のために使うかを示します。
元資料と制約を渡す
自社の数字、過去の資料、ブランドガイド、募集要項など、判断に必要な情報をまとめて渡します。さらに、期限、予算、対象地域、使ってよい表現、提出形式、利用できるツールを明示します。
元資料で確認できる事実と、外部調査で補った情報と、AIの仮説を分けるよう依頼すると、後の確認が容易になります。情報が足りない部分は推測で埋めず、質問または未確認事項として一覧化させます。
調査・作成・確認までを一つの仕事として任せる
最上位モデルの能力は、答えを一度生成するより、複数の工程をつなぐときに生きます。必要な情報を調べ、選択肢を比較し、方針を提案し、成果物を作り、元の条件と照合するところまで依頼します。
長時間の作業では、区切りも決めます。たとえば、調査方針を決めた時点、制作へ入る前、外部への送信や公開を行う前に、人が確認するよう指定します。 AIが自分で進める範囲と、人が判断する場面を分けることで、速さと安全性を両立できます。
完成条件を具体的にする
最後に、必須項目、文字数、形式、根拠の示し方、許容できない誤り、確認方法を伝えます。「初めて読む役員が10分で判断できる」「各案の費用・期間・リスクを同じ項目で比較する」「数値には出典または計算式を付ける」のように定めます。
実際の依頼は、次の形にまとめられます。
目的:誰が、何を判断・実行するために使うか
元資料:優先して使うファイル、数値、公式情報
制約:期限、予算、禁止事項、使えるツール
任せる範囲:調査、比較、方針決定、制作、確認のどこまでか
完成条件:必須項目、形式、根拠、確認方法
最上位モデルを使った効果は、 人が実際に使える成果物まで進んだか、確認と修正にかかる時間が減ったか で判断します。目的と完成条件が明確なら、モデルは途中の計画を立て直しながら、必要な工程へ能力を使えます。
まとめ
最上位AIモデルは、難しい質問への回答に加えて、 多くの資料から方針を決め、複数の工程とツールを使い、制作物や分析を完成させ、厳しく見直すところまで、AIへ任せられる範囲を広げます。
使い道として優先したいのは、デザインや資料などの大きな制作、長時間動くAIエージェント、専門的な調査・分析、重要な成果物のレビュー、複雑な開発・設計、高度な研究です。いずれも、最初の判断、長い文脈、途中の立て直しが成果を左右します。
一方、表記統一、項目抽出、分類、大量の定型処理では、標準・軽量モデルを使う方が速く、利用枠や費用も抑えられます。APIや独立したタスクでは、 方針と難しい判断は最上位、決まった方針での実行は標準、定型処理は軽量 と作業単位を分けられます。同じ長いローカルタスクではモデルを往復せず、別モデルへ任せる処理だけを別タスクにします。
まずは、現在抱えている仕事の中から、資料が多い、条件が複雑、複数の成果物をそろえる、公開前に厳しく確認したい、といった案件を一つ選んでください。Web版で最上位モデルを利用できるなら、目的、元資料、任せる範囲、完成条件を渡し、調査から確認まで進めます。ローカルアプリでは、選んだモデルを同じタスクで維持し、完成までの品質と利用枠を確認します。
最上位モデルを使っても、ハルシネーションや見落としは残ります。数値、引用、固有名詞、契約条件、最新情報は原文と照合し、最終的な判断を人が行います。 高性能なモデルに多くを任せながら、根拠と完成条件を人が管理することが、最上位AIモデルを仕事の成果へ変える使い方です。
参考記事・資料
- GPT-6 Astraの公式モデルガイド(OpenAI)
- GPT-6 Astraによる建築ビジュアライゼーション制作例(OpenAI)
- GPT-5.6とGPT-6 ProのChatGPTでの利用条件(OpenAI)
- Claude Fable 5.1の発表と用途(Anthropic)
- Gemini 3.8 Flashの推論・コーディング・エージェント用途(Google)
- Gemini 3 Deep Thinkの科学・研究・工学での事例(Google)
- Claude Opus 5とKimi K3を15課題で比較した記事(Tom's Guide)
- 27件のコーディング課題でモデルの段階利用を検証した公開草稿(GitHub)
- コード生成におけるパッケージ名のハルシネーションを調べた研究(arXiv)