Reasoning effortとは?ChatGPT・Claude・Geminiの推論レベルで何が変わるか
ChatGPTやClaude、Geminiを使っていると、「標準」「High」「拡張思考」「Deep Think」といった設定を見かけます。名前から、上げればAIが長く考えるのだろうとは想像できます。しかし、 実際に何を検討するのか、文章作成や調査でどのような差が出るのかまでは分かりにくいものです。
Reasoning effort(推論レベル)は、同じAIモデルが回答を出すまでに、条件整理、計画、比較、見直しへどれだけ処理を使うかを調整する設定です。 レベルを上げると、複数の条件を保ったまま考えたり、一つの案で決めずに別案を比べたり、途中の結果を見て方針を直したりしやすくなります。
有料Web版を使っているなら、APIのように一回ごとのトークン料金を計算する必要はありません。 通常のチャットで利用上限を意識する場面も少ないため、重要な相談や提出物ではHighを選びやすいでしょう。
一方、CodexやClaude Codeなど、パソコン上のファイルを読み、検索やコマンド実行まで行うローカルアプリは事情が違います。一つの依頼でも多くのファイルを読み、作業と確認を繰り返すため、Web版の会話より利用枠を消費しやすくなります。 ローカルアプリでは、タスクを始めるときに必要な推論レベルを選び、長い同一チャットの途中では頻繁に変えない方が効率的です。 実装や整形を別タスクにできる場合は、必要な前提だけを渡してMedium・Lowへ分けられます。
OpenAIだけでなく、ClaudeとGeminiにも似た設定があります。 どのサービスを使う場合も、最初に押さえたいのは、推論レベルを上げると普段の仕事のどこが変わるかです。
この記事のまとめ
- 推論レベルを変えると、どの仕事でも検討量や回答速度に差が出る可能性があります。
- Highの価値が大きいのは、AI自身が方針、設計、作業の分け方、仮説を決める工程です。
- Highは方針や設計、Mediumは方針に沿った実行、Lowは定型処理に向きます。ただし、長い同一タスクでは頻繁に切り替えません。
- 有料Web版は重要な仕事をHighから始めやすく、ローカルアプリはタスク開始時やまとまった作業単位で設定を選びます。
- Highでもハルシネーションは残るため、一次資料、検索、出典、原文との照合が必要です。
1. Reasoning effortは、AIが回答までに使う「検討の余裕」
Reasoning effortでは、 回答や作業を完成させるまでに、条件を整理したり、別案を比べたり、結果を見直したりする余裕 を調整します。
たとえば、AIへ「この3つのサービスから、自社に合うものを選んで」と頼んだとします。低い推論レベルでは、目立つ機能や料金を拾い、早く結論を出す方向へ進みやすくなります。 高い推論レベルでは、利用人数、必要な機能、移行の手間、契約条件といった判断材料を整理し、候補ごとの長所と弱点を比べ、結論に矛盾がないか確認する余裕が増えます。
推論レベルを上げることと、回答を長くすることは別です。 短い回答を指定していても、その結論へ至るまでに複数案を比べることはできます。反対に、長文が返ってきても、条件や選択肢が十分に検討されているとは限りません。
推論レベルを上げると、6つの検討が増えやすい
OpenAIは、推論モデルが内部の推論トークンを使って、問題の分解、計画、複数案の検討、途中結果からの立て直しなどを行うと説明しています。OpenAIのReasoning modelsガイドで示されている働きを普段の仕事に当てはめると、 推論レベルの違いは主に次の6つへ現れます。
- 条件を整理する:予算、期限、対象者、禁止事項などを抜けなく扱う
- 手順を組み立てる:何から調べ、どの順番で作業するかを決める
- 複数案を比べる:最初に思いついた案だけでなく、別案と欠点も見る
- 道具を選ぶ:Web検索、ファイル確認、計算、コード実行を使い分ける
- 途中で立て直す:調べた結果が予想と違えば、進め方を変える
- 最後に照合する:依頼された条件と完成物を比べ、漏れや矛盾を探す
たとえば会議日程を決めるだけなら、参加者の空き時間を照合できれば十分です。新商品の企画書を作るなら、市場情報を調べ、顧客像を定め、複数案を比較し、数字と文章のつながりを確認する必要があります。 後者のように工程が多く、一つの見落としが後半まで響く仕事ほど、推論レベルを上げる意味が出てきます。
OpenAI・Claude・Geminiで、同じHighが同じ量とは限らない
推論レベルは3社共通の物差しではありません。
OpenAIは、主に回答前の内部推論へどれだけ処理を使うかという形で説明しています。 Claudeのeffortは少し範囲が広く、思考だけでなく、回答文、説明、ツール呼び出しを含む出力全体に影響します。 Anthropicの公式ドキュメントでも、高いeffortほど詳しく取り組みやすくなる一方、時間と使用トークンが増えるとされています。
Geminiは、問題の難しさに応じて思考量を動的に調整する仕組みを採用しています。 Geminiアプリでは「標準思考」「拡張思考」「Deep Think」などが用意され、複雑な問題ほど長く、または複数の方向から検討する設定を選べます。GoogleのGeminiアプリ向け案内では、標準思考は多くの質問向け、拡張思考は複雑な問題解決向け、Deep Thinkは最大限の並列推論を使う設定と説明されています。
そのため、ChatGPTのHighとClaudeのHigh、Geminiの拡張思考を「同じ深さ」として比べることはできません。モデルそのものの能力も、設定が作用する範囲も異なるからです。推論レベルは、別の会社へそのまま換算するのではなく、 今使っているサービスの中で、標準よりもう一段検討を増やす設定 として捉えると分かりやすくなります。
表示される「思考」は、内部の検討をすべて見せたものではない
AIサービスによっては、回答前に「条件を確認しています」「複数案を比較しています」といった思考の要約が表示されます。 これは、どの方向で作業しているかを知る手がかりにはなりますが、内部で行われた処理をそのまま完全に表示したものではありません。
どれだけ考えたかを判断するときは、表示時間や思考要約の長さだけを見ないでください。 依頼した条件が保たれているか、複数案の弱点まで比べているか、途中で見つけた問題を完成物へ反映しているかを見る方が役立ちます。
Reasoning effortは、回答前に条件を整理し、選択肢を比べ、結論を見直すための余裕を調整します。 条件が少なく、すぐ正誤を確かめられる仕事では低いレベルでも進められます。複数の資料や判断がつながる仕事では、Highを選ぶ価値が高まります。
2. Highでは、条件整理・計画・比較・見直しを綿密に進めやすい
推論レベルを上げると、計画だけでなく、実行や確認の進め方にも差が出ます。 なかでも高い推論量の効果が現れやすいのは、複数の条件を整理し、何をどの順番で進めるかを決める段階です。
たとえば、問い合わせ管理ツールを3社比較し、社内向けの提案書を作るとします。 料金が安いサービスを見つけるだけでは足りません。 利用人数に合うプランか、必要な機能が含まれるか、既存データを移せるか、現在使っているSlackと連携できるかまで確認する必要があります。
低い推論レベルでも、各社の料金や機能を表へまとめることはできます。ただし、 調査中に見つかった例外条件を提案書へ反映する、比較条件がそろっていないことに気づいて調べ直すといった動きは、推論レベルを上げた方が期待しやすくなります。
条件を読み直し、後の工程まで保つ
複雑な依頼では、最初に読んだ条件を最後まで保てるかが重要です。
「50人で使う」「月額予算は10万円以内」「Slack連携が必須」「日本語サポートが必要」という条件があった場合、 一つでも抜ければ結論が変わります。 料金表を作る段階では覚えていても、長い提案書へまとめる途中で日本語サポートの条件が落ちることもあります。
高い推論レベルでは、条件を一度読むだけでなく、各候補を比べるときや結論を出すときにも参照する余裕が増えます。効果を確かめるなら、文章量ではなく、 最初に渡した条件が結論まで残っているか を見てください。
一つの案で決めず、別案と欠点も比べる
答えを急ぐと、AIは最初に条件を満たした候補をそのまま推奨することがあります。 しかし実際の仕事では、最安の案、移行しやすい案、将来拡張しやすい案が同じとは限りません。
推論レベルを上げると、「価格は安いが必要な連携機能が上位プランにしかない」「初期費用は高いが移行作業を減らせる」といったトレードオフを比較しやすくなります。 企画を作る場合も、一案だけを膨らませるのではなく、複数案を並べて、採用しなかった理由まで整理できます。
候補を増やしすぎると、選択肢が散らかることもあります。推論レベルを上げた効果は、 目的に照らして各案の弱点を比べ、選んだ理由まで説明できているか で判断できます。
調べた結果が予想と違えば、進め方を変える
Web検索やファイル確認を伴う仕事では、最初の予想が外れることがあります。 想定していた料金プランが終了していたり、必要な機能が別料金だったりすれば、比較の前提から直さなければなりません。
推論レベルが高いほど、最初の計画へ固執せず、新しく得た情報に合わせて次の行動を変えやすくなります。 追加のページを確認する、比較表の列を増やす、結論を保留して不足情報を示すといった動きです。
この違いは、CodexやClaude Codeなどのローカルアプリでも現れます。不具合の原因が予想したファイルになければ、ログや関連コードを調べ、別の原因へ切り替える必要があります。ファイルの読み込み、検索、コマンド実行、テストが増えるほど利用枠も消費するため、 原因の仮説や調査順序を決める最初の段階にHighを使う と効果的です。
最後に依頼条件と成果物を照合する
調査や制作の品質は、各工程の正しさと、その結果が完成物へ反映されているかで決まります。 比較表では正しい金額を確認したのに、提案書だけ古い数字のまま残ることもあります。
推論レベルを上げると、最初の依頼と完成物を照らし合わせる処理へ余裕を使いやすくなります。 指定した項目がそろっているか、数字が一致しているか、結論を支える根拠があるかを確認する段階です。
ただし、Highを選べば必ず確認されるわけではありません。重要な仕事では、「料金は公式ページと照合する」「本文と表の数字を一致させる」「資料にない情報は不明と記載する」のように、確認してほしい内容も依頼に含めてください。 Highを選ぶだけで終わらず、確認項目まで伝えることで、見落としの少ない成果物を得やすくなります。
3. ChatGPT・Claude・Geminiで、推論レベルの名前と使い方は違う
ChatGPTでHighを使っていた人が、ClaudeでもHigh、Geminiでも最も高い設定を選べば同じ結果になるわけではありません。 各社でモデルの能力、設定が作用する範囲、標準の思考量が違います。
まずは、Web版やデスクトップアプリの画面に表示される名前を基準にしてください。 APIにも似た設定がありますが、普段のチャットで必要なのは、今使っているサービス内で一段上げるか、下げるかという判断です。
| サービス | 主な表示 | 最初に選びやすい設定 | さらに上げる場面 |
|---|---|---|---|
| ChatGPT | 中程度、高い、非常に高い、Pro/Light、Low、Medium、High、Extra Highなど | 重要な相談・計画・判断はHigh | 一つの難問はMax、分割できる大仕事はUltra |
| Claude | Low、Medium、High、XHigh、Max | Highが全体のバランスを取りやすい | 長時間のコーディングや大規模な調査 |
| Gemini | 標準思考、拡張思考、Deep Think | 日常利用は標準、複雑な判断は拡張思考 | 複数の方向から深く検討する難問 |
利用できる名称は、モデル、契約プラン、提供時期によって変わります。 現在の画面に表示されている選択肢を基準にしてください。
OpenAIは、必要な品質に応じて段階を上げる
OpenAIの推論レベルは、利用する画面やモデルによって表示が変わります。 ChatGPTでは「中程度」「高い」「非常に高い」「Pro」、またはLight/Low、Medium、High、Extra Highなどが表示されます。
OpenAIのモデル選択ガイドでは、 短く範囲が明確な仕事はLightやLow、計画が必要な仕事はMedium、複数の工程・情報源・トレードオフを扱う仕事はHigh以上 が目安です。
Maxは、一つの難しい仕事へ長く取り組ませたい場合の選択肢です。 Ultraは、単純に一つのモデルがさらに長く考える設定ではなく、仕事を複数の担当へ分けて進める仕組みです。広いセキュリティレビューのように、認証、入力処理、依存関係を分けて調べたい場合はUltraが合います。一つの不具合の根本原因を深く追う場合はMaxが合います。
Claudeは、Highが品質と速度の基準になる
Claudeのeffortには、Low、Medium、High、XHigh、Maxがあります。 Claudeの公式ヘルプでは、LowとMediumは日常的な作業、Highは品質と速度のバランス、XHighは長時間のコーディングやエージェント作業、Maxは最も深い検討が必要な仕事向けとされています。
Claudeでは、Highが既定値になっているモデルもあります。その場合、Highへ変更するというより、簡単な仕事だけMediumやLowへ下げる使い方ができます。 XHighやMaxは、Highで完成しなかったという理由があるときに選べば十分です。
Geminiは、標準思考から拡張思考、Deep Thinkへ上げる
Geminiでは、標準思考が多くの質問に向く設定です。 比較条件が多い相談、複雑な分析、数学やコードの問題では拡張思考が候補になります。
Deep Thinkは、Google AI Ultraなど対象プランで提供される最上位の思考設定です。 複数の考え方を並行して検討するため、回答まで数分かかる場合があります。通常の質問をすべてDeep Thinkへ回すのではなく、拡張思考でも判断材料が不足した難問へ使ってください。
3社の設定を横一列に並べるより、今使っているサービスの標準設定で何が足りなかったかを見て、一段ずつ上げる方が選びやすくなります。
4. 有料Web版はHighを選びやすく、ローカルアプリは利用枠を見て使う
推論レベルの選び方は、利用する画面によって変わります。 有料Web版では重要な仕事をHighから始めやすく、ローカルアプリでは利用枠を考えてHighを使う工程を選びます。
Highにするか迷ったら、その工程でAI自身が考え方を決める必要があるかを確認してください。 比較軸や構成、実装方針から考えさせるならHighが向きます。すでに方針が決まり、数十秒で確認できる言い換えや整形を任せるなら標準設定で十分です。
Web版では、重要な成果物をHighから始めやすい
有料Web版にも利用上限はあります。 ただ、APIのように一回ごとの料金を計算する仕組みではないため、普段の質問では残りのトークン数を細かく追わずに使えます。
そのため、Web版では「節約のために常に標準へ下げる」より、仕事の重要度で決める方が実用的です。 社外へ出す文章、判断材料に使う比較、複数条件を含む相談はHigh、短い要約や言い換え、すぐ確認できる質問は標準という分け方なら、品質と応答速度を両立しやすくなります。
ローカルアプリでは、Highを使う仕事を選ぶ
CodexやClaude Codeのようなローカルアプリは、リポジトリ内のファイルを読み、関連箇所を検索し、コードを書き、コマンドやテストを実行します。 一つの依頼で扱う情報と処理が多いため、Web版の短い会話より利用枠へ早く達しやすくなります。
Claudeでは、Web、Desktop、Claude Codeの利用量が共通の上限へ算入され、モデル、effort、会話の長さ、使う機能によって消費が変わります。 OpenAIのChatGPT Workも、モデル、実行環境、推論設定、仕事の複雑さ、ツールによって消費量が変わります。
Geminiアプリにも、モデル、機能、会話の長さに応じた利用上限があります。 高い思考レベルを長く使う場合は、アプリに表示される上限案内を確認してください。
ローカルアプリでHighを使うなら、設計や調査方針を決める仕事、原因不明の不具合から仮説を立てる仕事を優先してください。方針が決まった実装、名前の変更、書式修正などを別タスクにできるなら、必要な前提だけを渡してMediumやLowで進められます。 同じ長いタスクを続ける場合は、後工程が少ないのに設定を変えたり、モデルを何度も往復したりしないことも、利用枠を生かすうえで重要です。
5. Highの価値が大きいのは、最初の計画や判断をAIに任せる工程
推論レベルを変えれば、どの仕事でも回答の速さ、検討の量、説明の詳しさに差が出る可能性があります。ただし、高い推論量を使う価値が特に大きいのは、 AI自身が考え方や進め方を決める工程 です。
記事作成なら、何を独自の切り口にするか、どの順番で説明するかを決める工程です。システム開発なら、原因が分からない不具合から仮説を立てる、複数の実装方法から方針を選ぶ工程です。 最初の計画や判断が決まれば、その後には決められた方針に沿って進められる作業も生まれます。
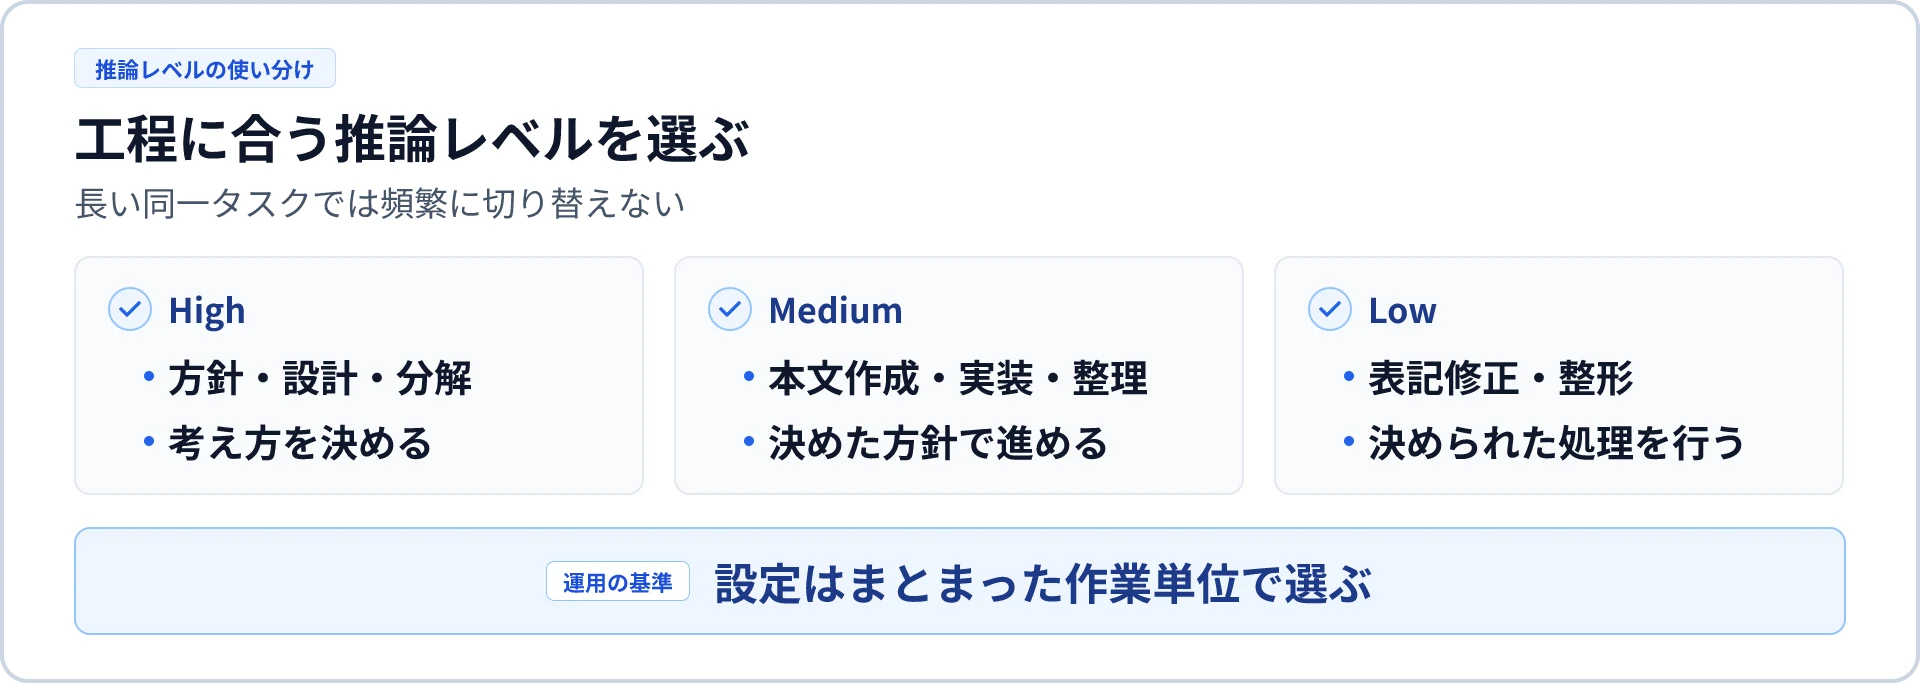
| 推論レベル | 向いている工程 | 仕事の例 |
|---|---|---|
| Low | 判断がほぼ不要な処理 | 整形、言い換え、名前変更、定型処理 |
| Medium | 方針が決まった後の実行 | 本文執筆、仕様に沿った実装、データ整理、既知の修正 |
| High | 方針・設計・分解・難しい判断 | 記事の独自性設計、提案書の論理設計、実装方針、原因不明のバグの仮説立て |
| XHigh以上 | Highでも難しい、長く複雑な判断 | 大規模設計、複雑な研究、広範なセキュリティ分析 |
Lowでも必要に応じて考え、Mediumでも判断を行います。 この表は厳密な境界ではなく、 タスクを始めるときや、まとまった作業単位を分けるときの選択基準 です。
工程に合わせて選ぶ。ただし、長いタスクの途中では頻繁に変えない
短いチャットや数ターンで終わる仕事なら、重要な判断をHighで始め、そのまま最後まで進めても大きな負担にはなりにくいでしょう。計画が終わった後に言い換えや表記修正が一、二回残っているだけなら、MediumやLowへ変更する必要性は高くありません。
一方、Codexなどのローカルアプリでは、会話、確認したファイル、検索結果、コマンドやテストの結果が積み重なります。長い仕事の途中で設定を何度も変えると、推論量を下げて節約できる分より、切り替えに伴う負担が大きくなる場合があります。
工程ごとに向く推論レベルが違うことと、同じ長いチャットで工程のたびに設定を変えることは別です。 後工程が短いなら現在の設定を維持し、変更する場合は、その設定でまとまった作業を続けられるかを見てください。
コンテキストが引き継がれても、キャッシュまで引き継がれるとは限らない
コンテキストは、過去の会話、確認したファイル、ツールの実行結果など、AIが現在の仕事を理解するために使う情報です。 Prompt Cacheは、その長い入力のうち、前回までと共通する部分の処理を再利用する仕組みです。
OpenAIは、Codexでは会話が続くほど入力が長くなる一方、共通する先頭部分をPrompt Cacheで再利用していると説明しています。モデルを変更すると、モデル固有の指示によって入力の先頭部分が変わり、キャッシュミスが起こる場合があります。 会話の内容が新しいモデルへ渡されることと、以前のキャッシュを再利用できることは別です。
reasoning effortの変更についても、Codexの公開Issueでは、変更直後の一回だけキャッシュヒット率が下がり、その次から戻ったという実測が報告されています。ただし、これは現行実装についての報告であり、常に同じ割合で発生する仕様ではありません。ChatGPT Workでも同じ変化が起こるかは、公開情報だけでは確認できていません。
キャッシュミスが直接増やすのは、主に切り替え直後の入力処理、利用量、応答時間です。ローカルアプリでモデル変更時に表示される性能低下の警告が、キャッシュだけを指すのか、モデルごとの能力や文脈理解の違いまで含むのかも、公式情報では内訳を確認できません。 警告の原因をキャッシュだけに限定せず、長い仕事の途中ではモデルを気軽に変えないための注意として受け取る のが安全です。
切り替えるなら、まとまった後工程か別タスクにする
Highで方針を決めた後、Mediumで進める実装や執筆が長く続くなら、一度変更して同じ設定を維持する方法が考えられます。反対に、Mediumへ変えて一回だけ作業し、すぐHighへ戻す使い方では、切り替えによる負担を回収しにくくなります。
モデルそのものを変える場合は、長く育った同じチャット内で往復するより、 必要な前提、対象ファイル、決定事項、完成条件をまとめて別タスクへ渡す 方が分かりやすくなります。難しい判断だけを高性能モデルへ任せる、完成物と確認項目だけを別タスクへ渡してレビューする、といった分け方なら、元の作業履歴をすべて引き継ぐ必要もありません。
記事作成なら、独自の切り口と構成を決めるタスクをHigh、決定済みの構成で本文を書く別タスクをMediumにできます。定型レビューだけを行う場合も、完成物、元資料、確認項目があれば、制作中の全会話を渡さずに進められます。
一回の消費ではなく、完了までの総量で判断する
Lowへ下げても、方針を誤って試行錯誤が増えれば、タスク全体の利用量は大きくなります。Highで最初に正しい方針を決め、少ない手順で完了できるなら、一回あたりの推論量が多くても、総量を抑えられる場合があります。
見るべきなのは、一ターンの推論量だけではありません。 完成までに使った総トークン・総クレジット、かかった時間、修正回数、成果物の品質をまとめて比べます。
High、Medium、Lowは、同じチャットで細かく切り替える手順ではなく、タスク開始時やまとまった作業単位で選ぶ設定です。短い後工程なら切り替えず、長い後工程なら一度変更して維持する。難所や独立したレビューは、必要な情報だけを渡した別タスクへ分ける。この運用なら、推論量だけでなくコンテキストとキャッシュの負担も考えられます。
モデル変更と推論レベル変更で起こる違いや、長いタスクを別タスクへ分ける判断基準は、「AIモデル・推論レベルを途中変更するときの注意点」で詳しく解説しています。
6. Highで改善しないときは、資料・指示・使える道具を見直す
Highへ上げても回答が良くならない場合、考える量ではなく、判断に必要な材料が足りていない可能性があります。情報がない状態で長く考えさせても、確かな事実は増えません。 むしろ、誤った前提を詳しく説明することがあります。
元の資料にない情報は、Highでも確定できない
社内の売上データを渡さずに「来期の売上予測を作って」と頼んでも、自社に合う予測は作れません。最新の料金を知りたいのにWeb検索が使えなければ、古い情報や一般知識へ頼ることになります。
まず、参照するファイルを渡す、Web検索を有効にする、対象期間を指定するといった形で、判断材料をそろえます。 Highで回答を作り直す前にAIが必要な資料を読める状態にすれば、根拠のない推測を減らせます。
「よいものを作って」では、完成条件が分からない
「よい企画書を作って」「詳しく調べて」という依頼では、何を満たせば完成なのかをAIが決めることになります。 推論レベルを上げても、読者が経営者なのか現場担当者なのか、比較したいのが価格なのか安全性なのかは確定できません。
対象読者、目的、残したい情報、提出形式、確認項目を加えてください。 たとえば「50人規模の会社向けに、料金とSlack連携を比較し、経営会議で読める2ページの提案書にする」と指定すれば、検討する範囲が定まります。
回答を短くしたい場合も、effortを下げるより「800字以内」「結論を先に」「表は一つ」と出力形式を指定する方が直接的です。 推論レベルは考える量を調整する設定であり、文章の長さや文体を決める設定ではありません。
Highで不足が残ったら、最初に資料、検索、完成条件を見直してください。 それでも複数案の検討や見直しが足りない場合に、XHigh、Max、Deep Thinkを選べば、最大設定へ上げる理由が明確になります。
7. Highでもハルシネーションは残り、発生率が必ず下がるとは限らない
推論レベルを上げれば、条件の見落としや論理の飛躍が減る場合があります。 しかし、存在しない事実や出典を作るハルシネーションまで、同じ割合で減るとは限りません。
論理の見落としと、事実の捏造は別の問題です。 計算の途中を長く検討することで誤答が減っても、学習データや参照資料に答えがなければ、事実を正しく補えるわけではありません。
推論レベルを上げて誤答が減る課題はある
グラフ上の関係を答える論理問題の研究では、推論レベルを上げて総誤答が減った条件でも、問題文にない関係を作る誤りは残りました。
対象は特定の論理問題です。 結果をそのまま、ほかのモデルや仕事のハルシネーション率として使うことはできません。
「Highにするとハルシネーションの確率は下がるのか」への答えは、 変わる可能性はあるものの、下がる割合も方向も仕事によって異なる です。条件の見落としが減っても、入力にない事実を作る誤りは残る場合があります。Highに共通する安全率はありません。
長く考えた結果、正しい答えを捨てることもある
問題の難しさと推論トークンの量を変えて正答率を調べた研究では、 長く考えるうちに、最初は正しかった答えを疑い、誤った候補へ変える「overthinking」 も確認されています。
問題がさらに難しくなると、考える量を増やしても解けない場合があります。 推論レベルは検討の余裕を増やしますが、モデルに新しい知識や能力を与える設定ではありません。
ハルシネーション対策は、根拠を渡して確認する
事実の正確さが重要な仕事では、Highを選ぶことに加えて、次の条件を依頼へ入れてください。
- 公式サイトや一次資料を優先する
- 数字、日付、固有名詞には出典を付ける
- 資料に書かれていない内容は推測で埋めず、「不明」と記載する
- 引用した内容と出典ページが一致するか確認する
- 契約、医療、法律、財務など重要な判断は人が原文を確認する
Highを選ぶときも一次資料を渡し、数字や固有名詞へ出典を付けさせてください。最後に原文と照合すれば、もっともらしい誤情報を成果物へ残しにくくなります。
8. 有料Web版はHighを基準にし、ローカルアプリは作業単位で設定を選ぶ
推論レベルは、その工程でAI自身が考え方を決める必要があるかで選びます。
High:考え方を決める
Medium:決めた考え方で進める
Low:決められた処理をする
OpenAI、Claude、Geminiでは、推論レベルを分ける基準が異なります。 ここでは、普段の仕事をどのレベルから始めるか決める目安として整理しています。
有料Web版は、重要な仕事ならHighのまま進めてもよい
有料Web版では、一回ごとのトークン数を計算する必要がなく、通常の利用で上限を意識する場面も多くありません。 重要な相談や成果物なら、計画から執筆までHighのまま進めても構いません。
短い質問、言い換え、すぐ確認できる作業では、標準設定へ下げると回答を早く受け取れます。 Web版でレベルを下げる理由は、主に利用量の節約ではなく、必要以上に待たず、会話のテンポを保つことです。 後工程が少ないなら、設定を変えずに終える方が簡単です。
ローカルアプリは、長いタスクの途中で設定を頻繁に変えない
ローカルアプリは、ファイルの読み込み、検索、コマンド実行、テストが重なり、利用枠へ達しやすくなります。 そのため、タスクを始めるときに、方針や設計まで任せるならHigh、決定済みの作業を進めるならMedium、定型処理ならLowを選びます。
長い同一タスクでは、計画が終わるたびにHighからMediumへ下げるのではなく、残っている作業量を確認します。数ターンで終わるなら同じ設定を維持し、変更後も長く作業が続く場合だけ切り替えます。モデルを変える必要があるときは、長いチャットの途中で往復するより、必要な前提と対象ファイルを渡した別タスクへ分ける方法があります。
記事作成なら、企画と構成だけをHighのタスクで決め、本文作成を別のMediumタスクへ渡せます。 開発でも、設計結果、変更対象、満たすテストをまとめて別タスクへ渡せば、制作中の全履歴を引き継がずに済みます。完成物の定型レビューも、元資料と確認項目がそろっていれば独立させられます。
MaxやDeep Thinkなど最上位の設定は、Highでも方針を決められない、検討する範囲が非常に広いときの選択肢です。 単純な作業量が多いだけなら、最上位設定の同じチャットで進め続けるのではなく、方針と実行を別の作業単位へ分けられるか検討します。
最上位モデル自体を使う仕事の選び方は、「最上位AIモデルは何に使うべき?高性能モデルが向く仕事・向かない仕事と実例」で詳しく解説しています。
GPT-6 Astraで推論レベルをどう選ぶかは、「GPT-6 Astraは何がすごい?できること・料金・推論強度を実例で解説」でも詳しく紹介しています。
有料Web版は重要な仕事をHighから始め、後工程が少なければそのまま完了させます。ローカルアプリは、タスク開始時やまとまった作業単位で設定を選び、長い同一チャットでは頻繁に変更しません。
まとめ
Reasoning effortは、AIが条件整理、計画、比較、ツール選択、途中の立て直し、最終確認へ使う余裕を調整する設定です。 高いレベルほど、複雑な条件を保ち、別案を比べ、途中で方針を直しやすくなります。
高い推論量の価値が大きいのは、AI自身が方針、設計、作業の分け方、仮説を決める工程です。Highは考え方を決める仕事、Mediumは決めた方針で進める仕事、Lowは定型処理に向いています。
難しい判断やレビューを独立させられる場合は、必要な前提、対象ファイル、完成条件、確認項目をまとめて別タスクへ渡します。設定を変えた一回の消費ではなく、完成までの総トークン・総クレジット、時間、修正回数、品質で効果を判断してください。
Highでもハルシネーションはなくなりません。 事実の正確さが必要なら、一次資料、検索、出典、原文との照合を組み合わせてください。資料や完成条件が足りない場合も、最大設定へ上げる前に入力を直す必要があります。
参考記事・資料
より詳しい仕様や利用例を確認したい方向けに、本文で参照した資料をまとめています。
公式情報
- OpenAI:Reasoning modelsガイド
- OpenAI:CodexのエージェントループとPrompt Cache
- OpenAI:Codex・ChatGPT WorkでPrompt Cacheを生かす仕組み
- OpenAI:Codexのモデル選択ガイド
- OpenAI:モデル選択ガイド
- OpenAI:ChatGPT Workの利用量とコスト
- Anthropic:effortの公式ドキュメント
- Anthropic:Claudeのeffortとthinking設定
- Anthropic:Claudeの利用上限
- Google:Geminiアプリの思考設定と利用上限
公開されている利用例
- Crystal Method:Claude Codeのeffort運用例
- Codex Issue:effort変更直後のキャッシュヒット率低下に関する報告
- Codex Issue:Astraのeffort変更時のキャッシュミスに関する報告
- Codex Issue:Astraのeffort変更をキャッシュへ反映する実装に関する報告
- DevelopersIO:Codexの推論レベル運用例
- Devoteam:Geminiの業務向け使い分け例