AIに知識を繰り返し使わせるには?MCP・RAG・Skillの選び方
AIへ同じ資料や手順を何度も渡していると、仕事のたびに準備が必要になります。手間を減らす方法を調べると、MCP、RAG、Skillといった技術が見つかりますが、どれを選ぶべきか分かりません。
ただし、困りごとは同じではありません。毎回の添付が負担なのか、必要な資料を見つけられないのか、同じ手順を繰り返し説明しているのかで、必要な方法は変わります。
この記事では、AIに知識を繰り返し使わせるときの困りごとを整理し、必要な仕組みの選び方を解説します。
この記事の要点|AIに知識を繰り返し使わせる仕組みはどう選ぶか
- AIに知識を繰り返し使わせる仕組みは、技術名から選ばず、同じ資料を毎回渡している、必要な情報を探せない、同じ手順を毎回説明している など、現在の困りごとから選びます。
- 資料が少ない間は、今使っているファイル、手動添付、資料の一覧と短い要約でも、AIが今回使う資料を選びやすくなります。
- MCPはAIを外部サービスにつなぎたいとき、RAGは必要な情報を検索しにくいとき、Skillは同じ仕事の手順を繰り返し説明しているときの選択肢です。
- 新しい仕組みは、現在の方法では負担を減らせないときに追加します。導入後は、添付、検索、説明、古い情報による修正の手間が減ったかを確認します。
最初は、一つの仕事と一つの困りごとを選ぶ
すべての技術を比較したり、複数の仕組みを同時に導入したりする必要はありません。まずは、AIへ繰り返し頼んでいる仕事を一つ選び、次の3つを確認してください。
- 毎回、同じ資料を添付しているか
- 必要な資料や箇所を探すのに時間がかかるか
- 同じ手順や出力形式を説明しているか
最も手間がかかっている問題を一つだけ選び、現在のファイルや機能で改善できるかを先に試します。この記事で紹介する方法を、最初からすべて取り入れる必要はありません。
知識を残す基準から、元データとの分け方、AIへ使わせるところまでの全体像は、AI時代のナレッジ管理全体ガイドで確認できます。
1. MCPやRAGを選ぶ前に、今の困りごとを5つに分ける
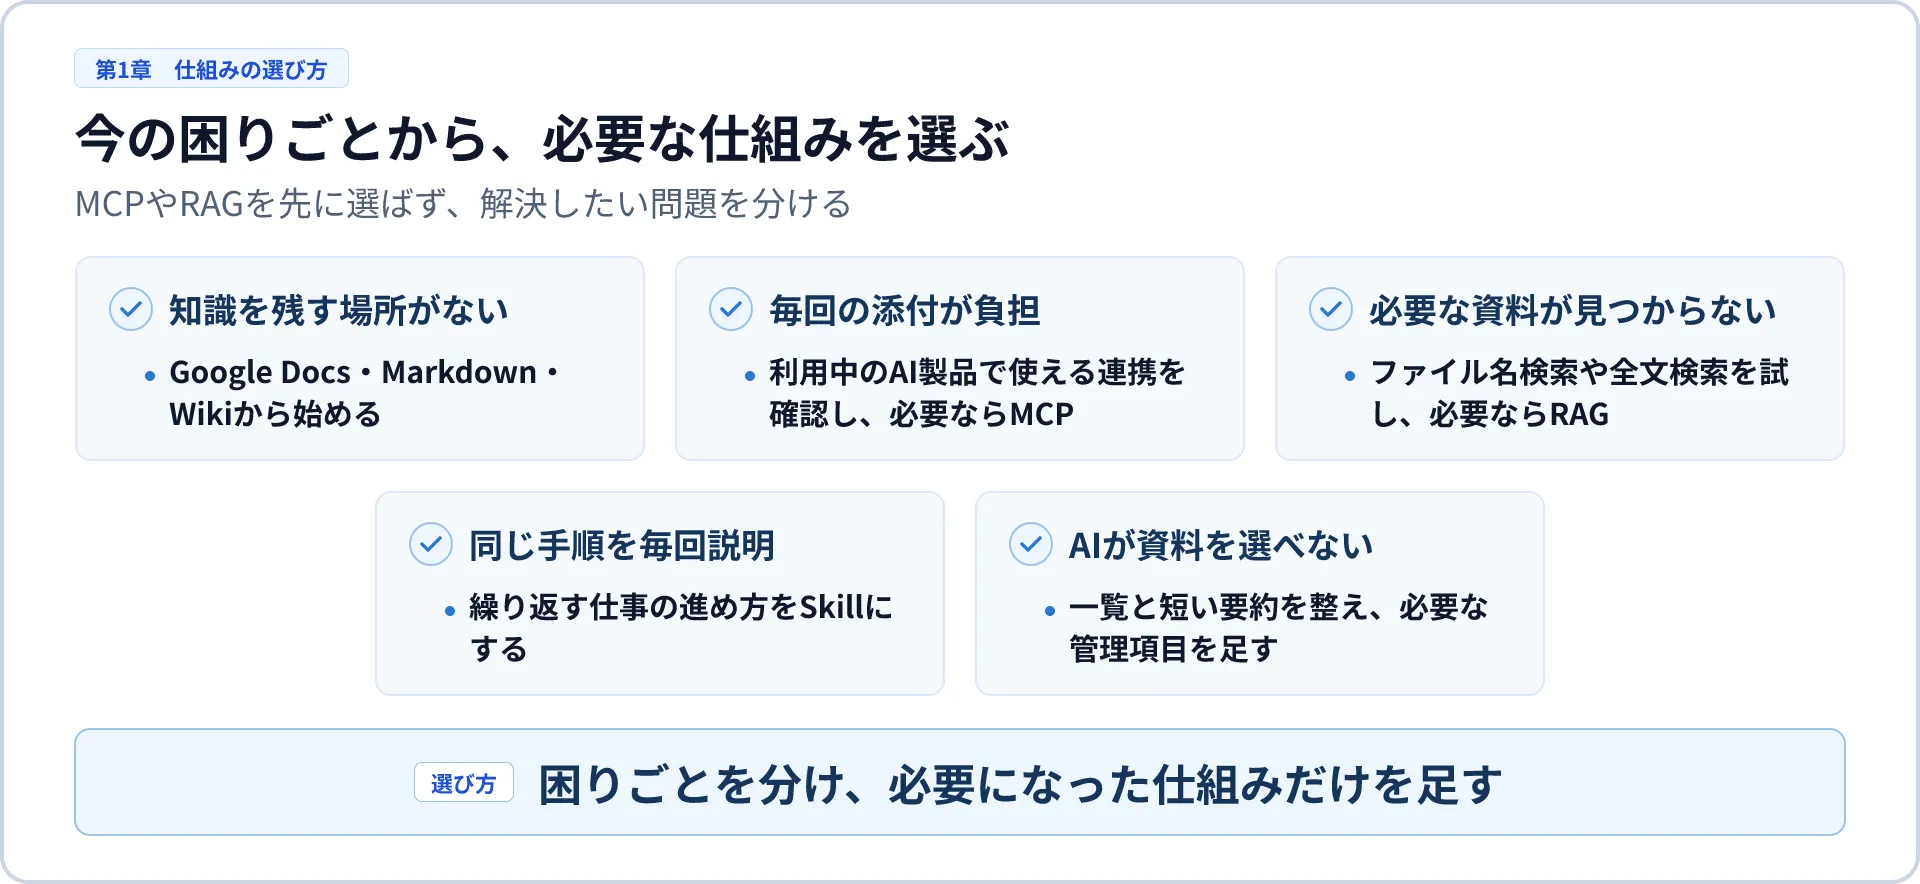 MCPやRAGを先に選ばず、現在の困りごとに必要な仕組みだけを足します。
AIに知識を使わせる仕組みを考えるときは、 技術名を比べる前に、現在の困りごとを5つに分けます。
| 分けて考えること | 確認する問い | 主な選択肢 |
|---|---|---|
| 知識の保存先 | 人が確認・更新する場所はあるか | Google Docs、Markdown、Wiki、データベース(DB)など |
| AIへの情報の渡し方 | AIがその場所の情報を使えるか | 手動添付、利用中の製品で使える連携、MCP |
| 必要な情報の検索 | 必要な内容を見つけられるか | 一覧、ファイル名検索、全文検索、RAGなど |
| 仕事の進め方 | 同じ進め方を毎回説明しているか | 手順書、Skill |
| 使う知識の選び方 | 見つかった資料のうち、どれを使うべきか判断できるか | 一覧、短い要約、必要に応じた補足、OKFなど |
例えば、AIへ毎回同じ3ファイルを添付しているものの、必要なファイル自体はすぐ見つかるとします。この場合はRAGを作るより、AIが現在の保存先を読めるようにする方が、毎回の添付を減らせます。
反対に、AIが共有フォルダを読めても、似た名前の資料が数百件あり、必要な箇所を見つけられないことがあります。この場合は、AIが保存先の情報を読めるようにする方法ではなく、必要な資料を見つける方法を見直します。
同じ資料を使えていても、確認順や出力形式を毎回説明しているなら、問題は仕事の進め方にあります。手順書やSkillを検討する場面です。
この5つは、上から順に取り組む手順ではありません。 必要な仕組みは、持っているファイルの数ではなく、現在の困りごとから決めます。 まずは、一番手間がかかっていることを一つ選んでください。
2. 新しい保存先を作らず、普段更新している資料をAIから使えるようにする
普段更新している資料を正本にする
最初に、人が普段確認し、更新している資料を特定します。 この記事では、最新の情報を確認するときに基準にする資料を「正本」と呼びます。
商品情報はGoogle Docs、顧客情報はCRM、編集方針はMarkdownというように、仕事では複数の保存先を使うことがあります。情報ごとにどの資料を正本にするかが決まり、更新する担当者も分かっているなら、現在の保存先をそのまま使えます。
AI用フォルダへ資料をコピーすると、AIには渡しやすくなります。一方、元の資料を更新するたびにコピーも直さなければなりません。更新が止まれば、AIだけが古い価格や以前の方針を使う状態になります。
そのため、 AI用コピーを増やす前に、正本をそのまま渡すか、AIが正本を直接読めるかを確認します。 コピーが必要な場合は、何のために作るのか、誰がいつ更新するのかまで決めてください。
保存形式は用途に合わせる
保存形式は、AIに合わせて統一せず、用途に合うものを使います。
- すでにGoogle Docsや社内Wikiを使っているなら、そのまま使う
- 文章中心で、ファイルとして扱いたいならMarkdownを使う
- 表形式で更新する情報なら、スプレッドシートやDBを使う
- 手元のパソコンとWebの両方から使いたいなら、既存のクラウドストレージで同期する
Markdownは、人がそのまま読めるファイル形式です。Gitなどで管理すれば、変更履歴も比較しやすくなります。顧客情報や案件進捗は、普段更新している業務システムを正本にすれば、同じ情報を二重に更新せずに済みます。
一覧は、AIが読む資料を選ぶ索引にする
保存先にどの資料があるか把握しにくい場合は、ファイル名と2〜3行の要約を並べた一覧を用意します。要約には、何が書かれているか、どの仕事で参照するかを短く記します。 この一覧は、人が管理項目を埋め続ける台帳ではなく、人やAIが読む資料を選ぶための索引です。 AIへ一覧を渡すと、今回の仕事に関係するファイルの候補を絞れます。保存先を参照できる環境なら、その候補から必要なファイルだけを開くようAIへ依頼できます。
資料が少ない間は、一覧に要約を直接書くだけでも構いません。資料が増えたら、各ファイルの冒頭に、内容を示す2〜3行のsummaryを付ける方法があります。こうしたファイル冒頭の管理情報をフロントマターと呼びます。AIにsummaryを読み取らせれば、資料の一覧を作れます。一覧と各ファイルの両方へ同じ要約を書くのではなく、どちらか一方を更新すれば済む形にしてください。
少量の知識なら、普通のファイルを必要なときに添付する方法から始められます。添付が負担になった時点で、AIへの情報の渡し方を見直してください。
3. 毎回の添付が負担になったら、AIへの情報の渡し方を見直す
必要な資料を見つけられても、仕事のたびにダウンロードして添付するのは手間です。 まず利用中の製品で使える連携を確認し、AIが元の保存先を読めるようにします。 目的に合う連携がなければ、MCPを検討してください。
手動添付で足りなければ、既存の連携を探す
AIから資料を読む方法は、使う製品や環境によって異なります。AIに読ませたい資料の数と、接続設定や権限管理にかかる手間を比べて選んでください。
| 方法 | 向く場面 | 導入後の変化 |
|---|---|---|
| 手動添付 | 少数の資料を、今回だけ確実に指定したい | 使う資料を自分で限定できる |
| 利用中の製品で使える連携 | 対応するDrive、Wiki、業務サービスを継続して参照したい | ダウンロードと再添付を減らせる |
| MCP | 既存の連携では使えない社内システムや独自サービスへ接続したい | 元の情報を読み、許可された操作まで続けられる |
一つの保存先を読む場合は、利用中の製品で使える連携が最初の候補です。資料が少なく、使うものを自分で指定したい場合は、手動添付が最も準備を抑えられます。独自のMCPサーバーが必要になった段階では、接続先の仕様、権限、運用方法を管理者や技術担当者と確認します。
ChatGPTやCodexでGmailやGoogle Driveなどを使いたい場合は、まず利用できるPluginを確認します。目的に合うPluginがあれば追加して使い、見つからない場合や社内システムへ独自に接続したい場合は、MCPを検討してください。
MCPなら、AIから外部情報を取得・操作できる
MCPを使うと、AIは外部サービスから情報を取得したり、許可された操作を行ったりできます。
例えば、顧客向けの提案書を作るとします。AIはMCP経由でCRMから顧客の最新状況を取得し、Driveにある現行の価格方針を読めます。保存の操作も許可されていれば、完成した下書きを指定の場所へ保存できます。
MCPを使えば、元の情報を毎回コピーせず、情報の取得から操作までを一続きでAIに任せられます。 MCPは外部の情報を使えるようにしますが、必要な情報をどう探すかは別に決めます。通常の検索で足りるか、RAGが必要かは、接続先で利用できる検索方法によって変わります。
接続できても、今回使ってよい情報とは限らない
AIが保存先を読めるようになっても、そこにある情報を無条件で使ってよいわけではありません。 顧客情報や人事情報を、すべての仕事で使ってよいとは限りません。AIが読める範囲、利用者の権限、情報を使う目的を確認してください。
接続できても必要な資料を見つけられなければ、次に見直すのは検索です。
4. 欲しい資料が見つからないときは、検索方法を見直す
まず既存の検索を試す
資料が増えても、すぐにRAGを導入する必要はありません。 まず、現在の検索で何が見つからないのかを確認します。
まず試せるのは、次の方法です。
- ファイル名とフォルダを分かりやすくする
- 各ファイルへ2〜3行の要約を付ける
- 全文検索を使う
- DriveやWikiなど、既存サービスの検索を使う
- AIサービスにファイル検索があるなら、その範囲で試す
この段階で必要な資料を見つけられ、仕事に使えるなら、現在の検索を続けます。AI製品や保存サービスに用意された検索機能を使うと、構築と保守の負担も抑えられます。独自RAGが候補になった段階で、検索対象、権限、更新方法を管理者や技術担当者と設計します。
文書と違う言葉でも探したいならRAGを検討する
一方、次のような問題が続く場合は、意味の近さを使う検索やRAGを検討できます。
- 質問で使う言葉と、文書に書かれた言葉が違う
- 多数の資料から、関係する箇所だけを取り出したい
- 部門、顧客、日付などで検索対象を絞りたい
- 検索結果を、そのままAIの回答作成へ使いたい
- 同じ種類の質問が繰り返され、毎回人が資料を探している
RAGは、質問に関係する情報を探し、見つけた内容をAIの回答に使う仕組みです。実現方法の一つに、文書を専用の保存先へ登録し、質問と意味が近い箇所を探す方法があります。この保存先は、ベクトルストア(Vector Store)と呼ばれます。
正確なファイル名や文書内の表現を知らなくても、普段使っている言葉で資料を探せます。 例えば「契約更新を迷っている顧客」と質問したとき、文書側に「継続利用への不安」と書かれていても、意味の近い情報を候補として見つけられます。日付や部門などを検索条件に加えれば、探す範囲も絞れます。
RAGを導入しても、古い資料や権限設定は自動では直らない
RAGは、古い資料を更新したり、誤った資料を直したりするものではありません。検索先に旧価格表しかなければ、AIは旧価格を使う可能性があります。アクセス権が広すぎると、本来は検索できない資料まで候補に入るおそれもあります。
RAGを導入する前に、どの資料を検索するか、どれが正本か、いつ更新されたか、誰が閲覧できるかを確認してください。 導入後は実際の質問を試し、回答の根拠になる資料が見つかるかも確かめます。
5. 同じ仕事の進め方を繰り返すならSkillにする
同じ知識を何度も使うことと、同じ仕事の進め方を何度も説明することは別です。
例えば記事レビューでは、次の二つがあります。
| 種類 | 内容 | 更新する場面 |
|---|---|---|
| 参照する知識(Knowledge/Reference) | 編集方針、表記ルール、品質基準 | 方針や基準が変わったとき |
| 仕事の進め方(Skill) | どの資料を読み、どの順に確認し、何を出力するか | 仕事の進め方を変えたとき |
編集方針そのものは、レビューで参照する知識です。一方、「編集方針を読み、構成、読みやすさ、表現、事実関係の順に確認して、レビュー結果を出す」という手順を毎回繰り返すなら、その手順をSkillにまとめられます。
外部サービスを使う仕事でも考え方は同じです。例えば、Gmailに接続できても、どのメールを確認し、どこまで処理するかまでは決まりません。「未返信メールを探す→重要なものを選ぶ→過去のやり取りを確認する→返信を下書きする」という作業を繰り返すなら、その手順をSkillにまとめます。
Skillへ知識そのものをためるのではなく、AIがどの資料を読み、どの順で確認し、どんな結果を返すかをまとめます。 具体的には、次の内容を決めておきます。
- どの依頼で使うか
- 最初に何を確認するか
- どの資料を読むか
- どの順に判断するか
- どの形式で結果を出すか
- 問題がある場合に、どこで止めるか
詳細な製品仕様、編集方針、顧客情報などをSkill本文へすべて詰め込む必要はありません。更新頻度が異なる知識は、参照資料(Reference)へ分け、必要なときに読みます。これにより、手順を変えずに知識だけ更新できます。
SkillはMCPがなくても使えます。手元のファイルを読み、決まった順で確認する仕事なら、指示とReferenceだけで始められます。外部サービスから最新情報を取得したり、結果を書き戻したりするときは、MCPなどのツールを組み合わせます。
進め方がまだ固まっていない仕事は、まず通常の依頼文や手順書で試してください。繰り返し使える判断と手順が見えてから、Skillにまとめます。
6. 知識が増えたら、AIが使う資料を選べるようにする
一覧と短い要約があれば、人やAIは何の資料があるかを把握できます。 知識を作成・更新する人やAIが増えたら、どれを使うべきか判断する手がかりを、実際の問題に合わせて足します。
ファイル冒頭の---で囲んだ部分をフロントマターと呼びます。ここではYAMLという、項目名: 値の形で情報を並べる書き方を使います。人やAIは本文を読む前に、資料の概要、更新時点、元の情報を把握できます。
---
summary: |
  A社の業務課題と、商談で確認した導入条件をまとめた資料。
  A社向けの提案や次回商談の準備で参照する。
updated: 2026-10-10
source: 2026年10月の顧客インタビュー
---
summaryは、人やAIが何の資料か把握するために使います。内容が変わりやすい資料にはupdatedを、元の情報へ戻る資料にはsourceを加えます。資料を選ぶ際に使う項目から増やしてください。フロントマターを自動生成・更新する仕組みが必要になった場合は、利用中の製品機能や技術担当者の支援も活用できます。
項目を増やすほど、更新する手間も増えます。新しい項目を加える前に、継続して更新できるかを確認してください。 更新されない項目が増えると、AIが資料を選ぶ際に使いにくくなります。
複数のAIで同じ知識を使うなら、項目名と書き方をそろえる
複数のAIやシステムで同じ知識を使うと、AIごとに項目名や書き方が異なり、情報を受け渡しにくくなることがあります。
Open Knowledge Format(OKF)を使うと、複数のAIが資料を選ぶときに確認する項目を、Markdownのフロントマターへ共通の書き方で記録できます。 OKFを知っておくと、AIやツールを増やしたときに、どの項目を共通化するか判断しやすくなります。少ない項目で管理できている間は現在の方法を続け、利用するAIや文書が増えて個別の決め方では扱いにくくなった段階でOKFを検討します。
7. 一つの繰り返し業務で、必要な仕組みだけ足す
最初から全社のナレッジ基盤を設計せず、 AIへ何度も頼んでいる仕事を一つ選びます。 顧客への提案書、月次レポート、記事レビューなど、使う資料とAIの出力を人が確かめやすい仕事から始めてください。
困りごとを一つだけ選ぶ
今の困りごとに近い行から、最初に試す方法を選んでください。
| 今の困りごと | 最初に試す方法 | それでも足りない場合 |
|---|---|---|
| 知識を残す場所がない | 既存のGoogle Docs/Markdown/Wiki | 用途に合う共有場所を決める |
| 同じ資料を毎回添付している | 利用中の製品で使える連携を確認する | 目的に合う連携がなければMCPを検討する |
| 資料を見つけられない | ファイル名・全文・サービス内検索 | 意味の近さで探せるRAGを検討する |
| 同じ手順を毎回説明している | 手順書や定型プロンプト | Skillを検討する |
| 見つかった資料のどれを使うべきか判断できない | 一覧と短い要約を整える | 困っている点に必要な項目を足し、複数AI間ならOKFを検討する |
次の順で試してください。
- AIへ繰り返し頼む仕事を一つ選ぶ
- その仕事で使う正本と、現在AIへ渡している方法を書く
- 上の表の5つのうち、どこで手間や失敗が起きているか確認する
- 最も大きな困りごとに対して、導入と管理の負担が小さい方法を一つだけ足す
- 変更前より負担や失敗が減ったか確認する
AIに整理を手伝わせる依頼例
どこから見直すか迷ったら、現在の困りごとをAIに整理させることもできます。次のように依頼してください。
以下の仕事で、AIに知識を繰り返し使わせる方法を見直します。

仕事:
現在使っている資料と保存先:
現在AIへ渡している方法:
困っていること:

次の5つを分けて整理してください。
1. 知識の保存先の問題
2. AIへの情報の渡し方の問題
3. 必要な情報の検索の問題
4. 仕事の進め方の問題
5. どの知識を使うか判断する問題

現在の困りごとを解決でき、導入と管理の負担が最も小さい方法を一つ提案してください。
RAG、MCP、Skillなどを導入する場合は、普通のファイル、手動添付、既存検索、手順書では足りない理由も示してください。
効果は、減った負担で確かめる
導入後は、実際の仕事で手間や失敗が減ったかを確認します。次のうち、今回の変更と関係するものを一つか二つ選んでください。
- 毎回の添付や前提説明にかかる手間
- 資料を探す時間
- 古い情報を使ったために、成果物を修正した回数
一つの方法で別の問題まで解決しようとしないことも大切です。MCPで接続できても検索に困るなら、次に検索を見直します。RAGで情報を見つけられても同じ確認手順を毎回説明しているなら、次にSkillを検討します。
困りごとが出た段階で、必要な仕組みだけを足します。 これを繰り返す方が、使わない機能を含む完成形を先に作るより、実際の仕事に合う形を選びやすくなります。
AIへ使わせる固有情報の整え方は、一覧と短い要約から始めるコンテキスト管理で説明しています。
まとめ
AIに知識を繰り返し使わせるために、最初からRAGや専用のナレッジ基盤を作る必要はありません。
まずは、人が確認・更新している正本をそのまま使い、一覧と短い要約を用意します。これだけでも、人やAIが必要な資料を選びやすくなります。毎回の添付が負担なら、利用中の製品で使える連携を確認してください。目的に合う連携がなければ、MCPを検討します。欲しい情報が見つからないなら、検索を見直します。同じ仕事の進め方を繰り返すなら、Skillにまとめます。
知識が増えてAIが使う資料を選びにくくなったら、困っている点に必要な項目だけを追加します。 新しい項目を増やす前に、継続して更新できるかを確認してください。 複数のAIやシステムで同じ知識を使い、個別の書き方では管理しにくくなった段階で、OKFなどを検討します。
保存先、AIへの渡し方、検索、仕事の進め方、使う資料の選び方を別々に考えると、今直すべきところが見えます。 まずは最近AIへ繰り返し頼んだ仕事を一つ選び、どこで手間や失敗が起きているかを書き出してみてください。そこへ、導入と管理の負担が小さい方法を一つだけ足します。
参考資料
AI実務
関連記事
同じ領域から、現在の記事に近い内容を紹介します。